
openpipe
Piattaforma di gestione per il fine-tuning di LLM che raccoglie dati di interazione e automatizza l'addestramento e l'hosting dei modelli.
Visite Mensili
34.7K
Durata Media
0 min
Posizione Categoria
#8384
Frequenza di Rimbalzo
0.4%
Cos'è openpipe?
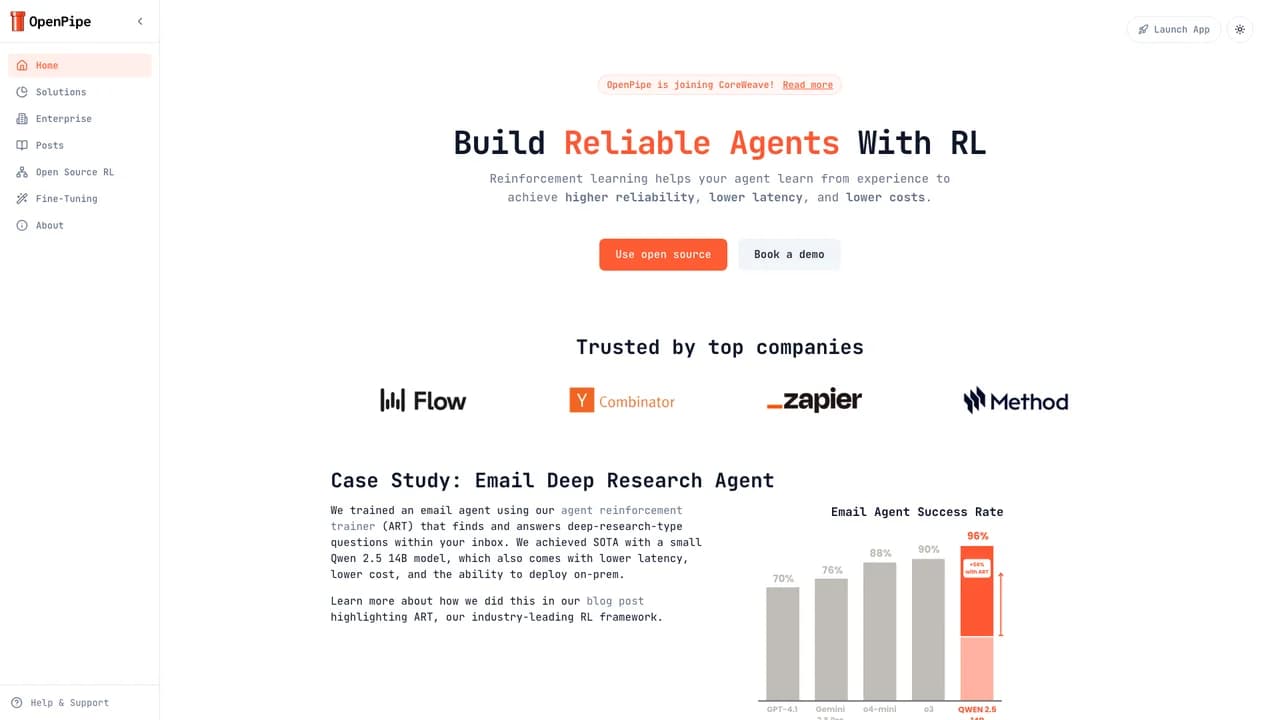
OpenPipe è una piattaforma AI efficiente progettata per team di prodotto e sviluppatori, che permette di addestrare modelli linguistici di grandi dimensioni (LLM) dedicati per sostituire costose e inefficienti chiamate API basate su prompt. La piattaforma utilizza un SDK unificato per catturare tutte le interazioni prompt-risposta, semplificando la generazione di dataset e l'esecuzione del fine-tuning. OpenPipe automatizza la raccolta dei dati, la loro filtrazione, la valutazione e l'hosting dei modelli, offrendo velocità di inferenza più elevate, maggiore precisione e significativi risparmi sui costi. Supporta inoltre la conformità a SOC 2, HIPAA e GDPR, rendendola adatta ad ambienti produttivi sensibili e su larga scala.
Funzionalità chiave di openpipe?
Prezzi
- Prova gratuita: Inizia con OpenPipe con una prova gratuita di 30 giorni.
- Piano Standard: A partire da $50,00 per mese, offre funzionalità di base adatte a piccoli progetti.
- Piano Enterprise: Prezzi personalizzati in base ai requisiti e alla scala specifici.
Disclaimer: Per i dettagli sui prezzi più accurati e aggiornati, fare riferimento al sito Web ufficiale di OpenPipe.
Alternative a openpipe

unify-ai
Unify AI fornisce agli sviluppatori una piattaforma centralizzata per accedere e confrontare le prestazioni di più modelli linguistici di grandi dimensioni (LLM) di vari fornitori tramite una singola API. Instrada dinamicamente le richieste al modello con le migliori prestazioni in base a metriche in tempo reale come qualità, velocità e costo. La piattaforma aggiorna continuamente i propri benchmark ogni 10 minuti, consentendo una selezione ottimizzata del modello in base a vincoli definiti dall'utente. Unify AI supporta inoltre l'integrazione con popolari strumenti di orchestrazione LLM, offrendo un ambiente modulare e personalizzabile per la registrazione, la valutazione e l'ottimizzazione delle implementazioni LLM.

superglue
superglue è un connettore dati open-source con auto-riparazione, progettato per semplificare integrazioni API complesse generando, convalidando e mantenendo automaticamente la logica di trasformazione dei dati. Agendo come proxy tra la tua applicazione e API esterne o legacy, gestisce autenticazione, impaginazione, nuovi tentativi in caso di errore e validazione dello schema. Sfruttando modelli linguistici di grandi dimensioni, superglue mappa e trasforma automaticamente i dati nella struttura precisa che definisci, riducendo significativamente lo sforzo di sviluppo ed evitando la dipendenza dal fornitore. Supporta un'ampia gamma di fonti dati, incluse API, file e sistemi legacy, e può essere self-hosted o utilizzato come servizio gestito.

lm-studio
LM Studio è un'applicazione desktop versatile progettata per eseguire e sperimentare con modelli linguistici di grandi dimensioni localmente sul proprio dispositivo, senza richiedere una connessione internet. Con supporto per le piattaforme macOS, Windows e Linux, è compatibile con runtime open-source come llama.cpp e MLX di Apple, garantendo un'esecuzione efficiente dei modelli. Gli utenti possono sfogliare e scaricare un'ampia gamma di LLM dal repository Hugging Face, interagire con i modelli attraverso un'interfaccia simile a ChatGPT e sfruttare funzionalità avanzate come l'RAG per l'interazione con documenti offline. LM Studio fornisce inoltre un server API locale compatibile con OpenAI, permettendo un'integrazione senza soluzione di continuità con applicazioni e script personalizzati, garantendo al contempo la privacy dei dati e il controllo completo sui carichi di lavoro di intelligenza artificiale.

escape
Escape è una moderna piattaforma di sicurezza concepita per aiutare le organizzazioni a scoprire, catalogare e proteggere automaticamente tutte le API e applicazioni web esposte, senza richiedere configurazioni complesse o modifiche alla rete. Offre analisi continue e non invasive degli ambienti di produzione e test di sicurezza applicativa dinamici (DAST), concentrandosi sulle vulnerabilità di business logic e fornendo approfondimenti dettagliati e indicazioni operative per la risoluzione direttamente all'interno dei flussi di lavoro di sviluppo. Escape supporta i framework web moderni, le API GraphQL e REST, e si integra senza soluzione di continuità nelle pipeline CI/CD per consentire l'individuazione e la risoluzione precoce dei problemi di sicurezza, riducendo il rischio e l'attrito operativo.

inferless
Inferless è una piattaforma all'avanguardia per l'inferenza serverless con GPU, progettata per semplificare e ottimizzare il deployment dei modelli di machine learning. Gli sviluppatori possono distribuire modelli con una configurazione quasi zero da sorgenti diverse come Hugging Face, Git e Docker, scalando elasticamente fino a centinaia di GPU su richiesta. La piattaforma massimizza l'utilizzo della GPU attraverso un bilanciamento del carico consapevole dell'infrastruttura e batch dinamici, riducendo la latenza di avvio a freddo a pochi secondi, fornendo al contempo pipeline CI/CD automatizzate. Con ambienti isolati in sicurezza e runtime personalizzabili, supporta un'ampia gamma di carichi di lavoro di intelligenza artificiale, inclusi chatbot basati su LLM, visione artificiale, generazione audio e altro ancora, rendendola la scelta ideale per inferenze ML di produzione su larga scala.

cirrascale-cloud-services
Cirrascale Cloud Services offre un'infrastruttura cloud dedicata, progettata per applicazioni impegnative di IA e high-performance computing. Consente un deployment senza soluzione di continuità di modelli di IA generativa, visione artificiale ed elaborazione del linguaggio naturale con una tariffa forfettaria flessibile e nessun costo nascosto. La piattaforma supporta un'ampia gamma di acceleratori GPU, reti ad alta velocità e soluzioni di storage multilivello, consentendo alle organizzazioni di scalare in modo efficiente l'addestramento, l'inferenza e i carichi di lavoro intensivi di dati. Cirrascale fornisce anche servizi gestiti per semplificare la gestione dell'infrastruttura e ottimizzare le prestazioni per le iniziative aziendali di IA e HPC.


