
ttsvox
Eine webbasierte Text-in-Sprache-Plattform, die über 50 Sprachen und 200+ Sprachoptionen zur Umwandlung von Text in Audio unterstützt.
Monatliche Besuche
2.9K
Ø Sitzungsdauer
0 min
Kategorie-Rang
#4768
Absprungrate
0.4%
Was ist ttsvox?
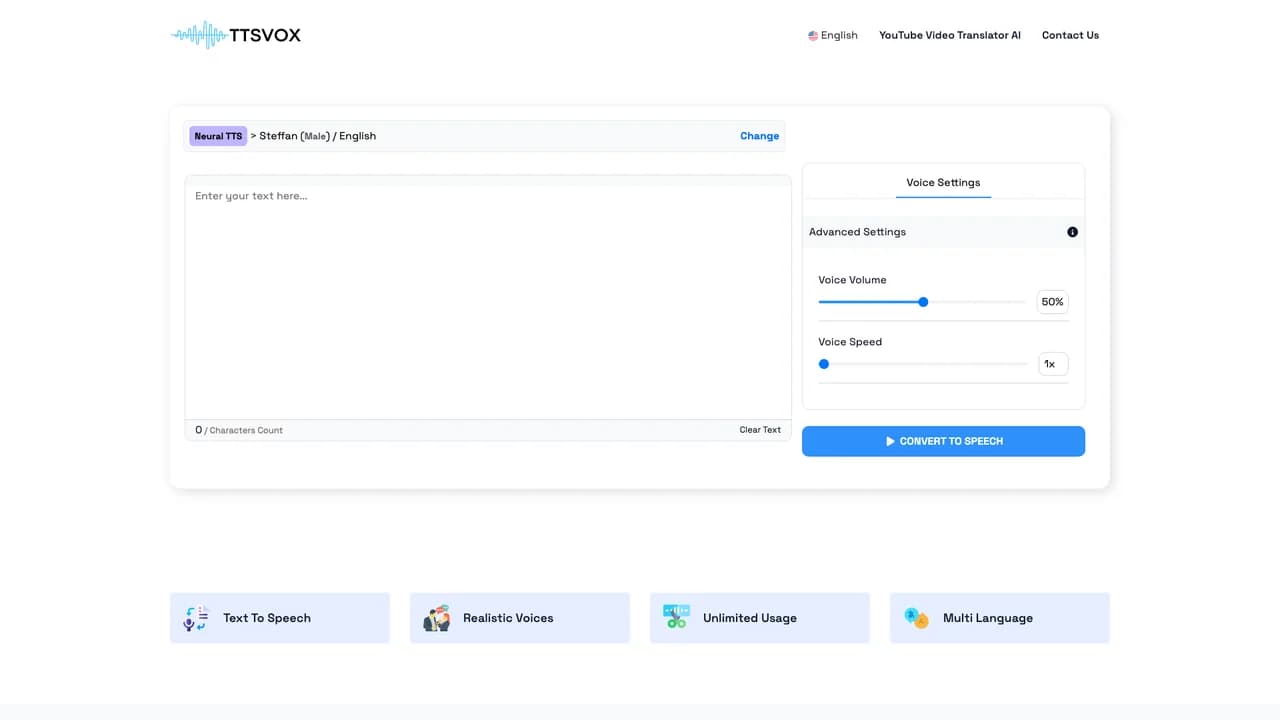
TTSVox ist eine webbasierte Text-in-Sprache-Plattform, die jeden Text in natürliche, hochwertige Audioausgaben umwandelt. Mit Unterstützung für über 50 Sprachen und 200 Sprachoptionen – einschließlich verschiedener Akzente und Geschlechter – können Sie die Sprachausgabe nach Ihren Bedürfnissen anpassen. Für Barrierefreiheit und breite Anwendbarkeit konzipiert, ist TTSVox ideal für Anwendungen wie Videocommentare, Online-Bildung, IVR-Systeme und Audio-Artikel. Der Dienst steht für unbegrenzte Nutzung zur Verfügung, ohne dass Downloads oder Installationen erforderlich sind. Dies macht ihn für Studierende, Fachleute und Content-Ersteller jederzeit bequem nutzbar.
Hauptfunktionen von ttsvox?
Alternativen zu ttsvox

lang-lang-dubbing
Langlang AI Voice ist eine umfassende Text-to-Speech-Plattform, die geschriebenen Text in natürlich klingende Sprache in über 30 Sprachen – darunter Chinesisch, Englisch, Deutsch, Französisch, Italienisch, Spanisch und Indonesisch – umwandelt. Die Plattform bietet mehr als 200 Sprachmodelle mit einer Vielzahl emotionaler Stile, von fröhlich und traurig bis hinzu aufgeregt und ängstlich. Sie unterstützt erweiterte Funktionen wie SSML-Tags zur präzisen Sprachsteuerung, Multisprecher-Erzählungen, die Integration von Hintergrundmusik sowie Soundeffekte. Nutzer können hochwertige Audioinhalte generieren, die für die kommerzielle Nutzung geeignet sind, und behalten die vollständigen Urheberrechte. Dies macht die Plattform ideal für Videosprecher, die Hörbuchproduktion, Werbung und Bildungsinhalte.

yueyin-voice-synthesis
Yueyin Peiyin ist eine umfassende Sprachgenerierungsplattform von Zhipianbang, die Text in natürliche und flüssige Sprache konvertiert. Die Plattform verfügt über eine umfangreiche Sprachbibliothek mit einer breiten Palette an Stimmen verschiedener Geschlechter und Altersgruppen und unterstützt Hochchinesisch, verschiedene regionale Dialekte sowie mehrere internationale Sprachen, um unterschiedliche kreative Anforderungen zu erfüllen – von Video-Sprechertexten bis hin zu Bildungsinhalten. Durch die Kombination von automatischer Sprachsynthese mit professionellen Sprecherdienstleistungen bietet Yueyin Peiyin flexible, auf verschiedene Qualitätsanforderungen und Budgetbeschränkungen zugeschnittene Lösungen.

ciniao-voice
Ciniao Voice ist eine All-in-One-Text-to-Speech-Plattform, die fortschrittliche Sprachsynthestechnologie nutzt, um geschriebene Inhalte in natürliches und flüssiges Audio umzuwandeln. Die Plattform bietet über 200 verschiedene Sprachoptionen, darunter beliebte Stimmen wie Magic Yunxi und Magic Xidu, und unterstützt mehrere Sprachen und Dialekte, einschließlich Mandarin, Englisch, Kantonesisch, Sichuanesisch, Nordostchinesisch, Hunanesisch und Taiwanesisch. Benutzer können Sprechgeschwindigkeit, Tonlage, Lautstärke und Hintergrundmusik anpassen, um problemlos professionelle Audioinhalte zu erstellen, die vielfach einsetzbar sind, beispielsweise in Kurzvideos, Film- und Fernsehsynchronisation, Lehrmaterialien und Hörbüchern.

sesame-ai
Sesame AI ist ein fortschrittliches konversationelles Sprachmodell, das in der Lage ist, hochgradig natürliche und menschenähnliche Sprachsynthese zu generieren. Im Gegensatz zu herkömmlichen Text-zu-Sprache-Systemen integriert das Sesame-Modell sowohl Text- als auch Audio-Kontext, um fließende, ausdrucksstarke Sprache zu erzeugen, die Emotionen, Intonation und Gesprächsdynamik präzise erfasst. Basierend auf einer groß angelegten Transformator-Architektur unterstützt es mehrsprachige und multivokale Ausgabe mit Echtzeitgenerierung und hoher Anpassungsfähigkeit. Sesame AI ist ideal für Entwickler, Content-Ersteller und Unternehmen, die darauf abzielen, authentische, natürliche Stimminteraktionserlebnisse zu schaffen.

typecast-ai
Typecast AI ist eine fortschrittliche KI-Sprachgenerierungsplattform, die Text in realistisch klingende Sprache mit präziser Kontrolle über Tonfall, Tonhöhe, Geschwindigkeit und Emotion umwandelt. Angetrieben durch das proprietäre Sprachsynthese-Grundmodell (Speech Synthesis Foundation Model, SSFM), liefert Typecast natürliche und ausdrucksstarke Sprache in über 20 Sprachen. Die Plattform bietet Zugang zu mehr als 550 KI-Sprechern und virtuellen Avataren und ermöglicht es Nutzern, effizient Audio- und Videoinhalte zu produzieren, ohne auf traditionelle Synchronstudios angewiesen zu sein. Mit einer intuitiven Benutzeroberfläche und nahtlosen Integrationsmöglichkeiten optimiert Typecast Arbeitsabläufe für Content-Ersteller, Pädagogen, Vermarkter und Entwickler.

speechgen
SpeechGen ist eine KI-gestützte Plattform, die geschriebenen Text in natürliche, fließende Sprache umwandelt und hochwertige Voiceovers in den Formaten MP3 oder WAV bereitstellt. Durch den Einsatz fortschrittlicher KI-Technologie zur Nachahmung menschlicher Sprechmuster bietet sie eine breite Palette an Sprachakzenten und Stilen. SpeechGen eignet sich für verschiedene Anwendungen, einschließlich Videos, Online-Bildung und Podcasts.


