
fish-audio
Text-to-Speech-Plattform mit Unterstützung für multilinguale Sprachsynthese und Sprachklonung aus kurzen Audiobeispielen
Monatliche Besuche
1.5M
Ø Sitzungsdauer
4 min
Kategorie-Rang
#567
Absprungrate
0.4%
Was ist fish-audio?
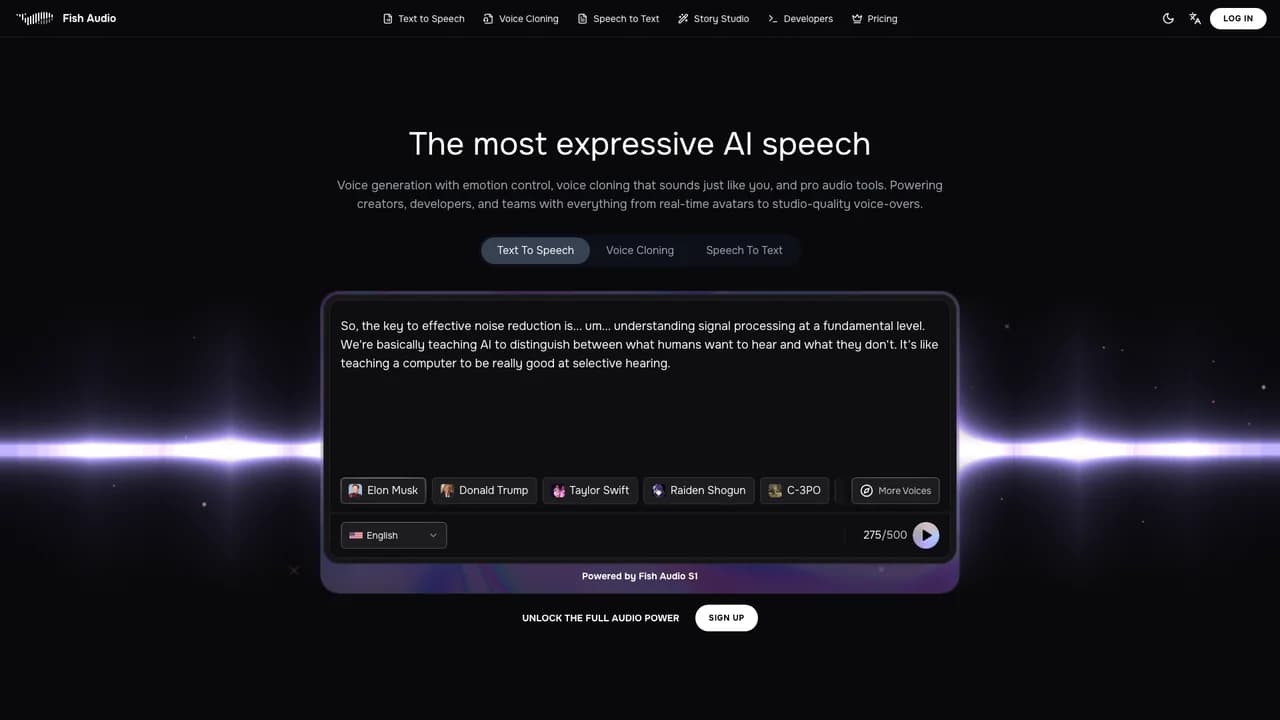
Fish Audio ist eine hochmoderne KI-Stimmplattform, die sich auf Text-to-Speech (TTS) und Sprachklon-Technologien spezialisiert. Mit der Unterstützung von über 200.000 Stimmen und mehreren Sprachen ermöglicht sie es Benutzern, effizient natürliche und ausdrucksstarke KI-Sprachaufnahmen zu generieren. Fish Audio zeichnet sich durch schnelle Sprachklonung aus kurzen Audiobeispielen aus, unterstützt Echtzeit-Sprachsynthese über eine WebSocket-API und erlaubt eine fein abgestufte Kontrolle von Stimmparametern wie Sprechgeschwindigkeit, Tonhöhe und emotionaler Färbung. Die Technologie findet breite Anwendung in den Bereichen Content-Erstellung, Entwicklungsumgebungen und Unternehmensdienstleistungen, einschließlich Hörbüchern, Werbung, mehrsprachigem Kundensupport und interaktiven Sprachassistenten.
Hauptfunktionen von fish-audio?
Alternativen zu fish-audio

playht
PlayHT ist eine führende KI-Sprachsyntheseplattform (Text-to-Speech, TTS), die fortschrittliche Künstliche Intelligenz und Machine-Learning-Technologien nutzt, um geschriebenen Text in natürliche, menschenähnliche Sprache umzuwandeln. Mit über 900 verfügbaren Stimmen in 142 Sprachen und Akzenten ermöglicht PlayHT Content-Erstellern, Pädagogen, Marketingspezialisten und Unternehmen, hochwertige Audioinhalte für Podcasts, Hörbücher, Online-Bildung, Sprachaufnahmen und IVR-Systeme zu produzieren. Die Plattform unterstützt Sprachklonierung, umfangreiche Stimm-Anpassung sowie nahtlose Integration über APIs und Plugins, wodurch sie sowohl für Einzelpersonen als auch für Unternehmensanwendungen geeignet ist.

ai-voice-cloning
AI Voice Cloning ist eine anspruchsvolle Sprachsyntheseplattform, mit der Benutzer hochrealistische Stimmreplikate mithilfe minimaler Audioaufnahmen erstellen können. Der Dienst kann lebensechte Stimmklone aus nur einem 3-Sekunden-Audioclip generieren und dabei die Originalintonation, Emotion und einzigartigen Stimmcharakteristika des Sprechers akkurat erfassen. Die Plattform bietet Unterstützung für mehrere Sprachen, einschließlich Englisch, Mandarin, Japanisch und Koreanisch, und eignet sich somit für eine weltweite Nutzerbasis. Durch ihre benutzerfreundliche Oberfläche und schnelle Verarbeitungsfähigkeiten erfüllt der Dienst sowohl persönliche als auch professionelle Stimmerzeugungsanforderungen.

uberduck-ai
Uberduck AI ist eine fortschrittliche Sprachsyntheseplattform, die auf neuronaler Netzwerktechnologie basiert, um geschriebenen Text in natürliche, lebensechte Audioausgaben umzuwandeln. Die Plattform verfügt über eine umfangreiche Sprachbibliothek, einschließlich Prominentenstimmen und fiktiver Charaktere, und befähigt Content-Ersteller, Vermarkter, Spieleentwickler und Unternehmen, ansprechende Sprachaufnahmen, Dialoge und Audioinhalte zu produzieren. Sie unterstützt Stimmklonierung und Stimmkonvertierung und bietet eine Vielzahl von Anpassungsoptionen wie Tonhöhe, Sprechgeschwindigkeit und Akzentanpassung. Mit mehrsprachiger Unterstützung und API-Integration erfüllt Uberduck AI vielfältige kreative und kommerzielle Anforderungen, und ihre benutzerfreundliche Oberfläche macht sie für Anfänger und Profis gleichermaßen zugänglich.
Listnr
Listnr ist ein modernster AI-Sprachgenerator, der Text in realistische, menschenähnliche Sprachaufnahmen umwandelt. Es bietet ein bemerkenswertes Sortiment von über 1000 Stimmen in 142 Sprachen, inklusive Optionen für das Klonen von Stimmen. Dieses Tool wurde entwickelt, um Content-Ersteller, Vermarkter, Pädagogen und Unternehmen anzusprechen, die ihre Multimedia-Präsentationen mit hochwertigem Audio verbessern möchten. Egal, ob Sie YouTube-Videos, Podcasts oder ansprechende E-Learning-Module erstellen – Listnr bietet eine effiziente und vielseitige Lösung, um verschiedene auditive Bedürfnisse zu erfüllen.

audie-ai
Audie AI ist ein fortschrittliches, KI-gestütztes Hörbucherstellungstool, das Textinhalte innerhalb weniger Stunden effizient in professionell gesprochene Hörbücher umwandelt. Durch die Nutzung einer branchenführenden Text-zu-Sprache-Technologie bietet die Plattform natürliche, ausdrucksstarke Stimmen mit anpassbaren Sprechgeschwindigkeiten und Intonationen. Nutzer können aus einer Vielzahl von Stimmen wählen oder ihre eigene Stimme klonen, um ein personalisiertes Hörerlebnis zu erreichen. Audie AI reduziert die Produktionskosten auf nur ein Zehntel der Kosten traditioneller menschlicher Sprecher und ermöglicht es Autoren und Verlagen so, Hörbücher einfach und kostengünstig zu erstellen. Die Ausgabedateien der Plattform sind mit großen Vertriebskanälen wie Amazon kompatibel, was dazu beiträgt, den Veröffentlichungsprozess zu optimieren und die Reichweite bei der Zielgruppe zu erweitern.

voicemaker
Voicemaker ist ein fortschrittliches Online-TTS-Tool, das Text in hochwertige, lebensechte Sprache umwandelt. Es unterstützt mehrere Sprachen und Akzente und eignet sich für ein breites Anwendungsspektrum wie Videos, Hörbücher, Online-Bildung und Kundenservice. Die Plattform bietet anpassbare Funktionen, darunter Sprechgeschwindigkeit, Tonhöhe, Lautstärke, Pausen und Audioeffekte, die es Nutzern ermöglichen, personalisierte Audioinhalte zu erstellen. Mit einer benutzerfreundlichen Oberfläche und API-Unterstützung ist es ideal für Content Creator, Unternehmen und Entwickler. Die generierten Audiodateien sind mit Nutzungsrechten versehen.


