
elevenlabs
Plataforma de conversão de texto em fala que gera vozes multilíngues naturais e suporta conversão de voz.
Visitas Mensais
22.5M
Duração Média
5 min
Posição na Categoria
#38
Taxa de Rejeição
0.4%
O que é elevenlabs?
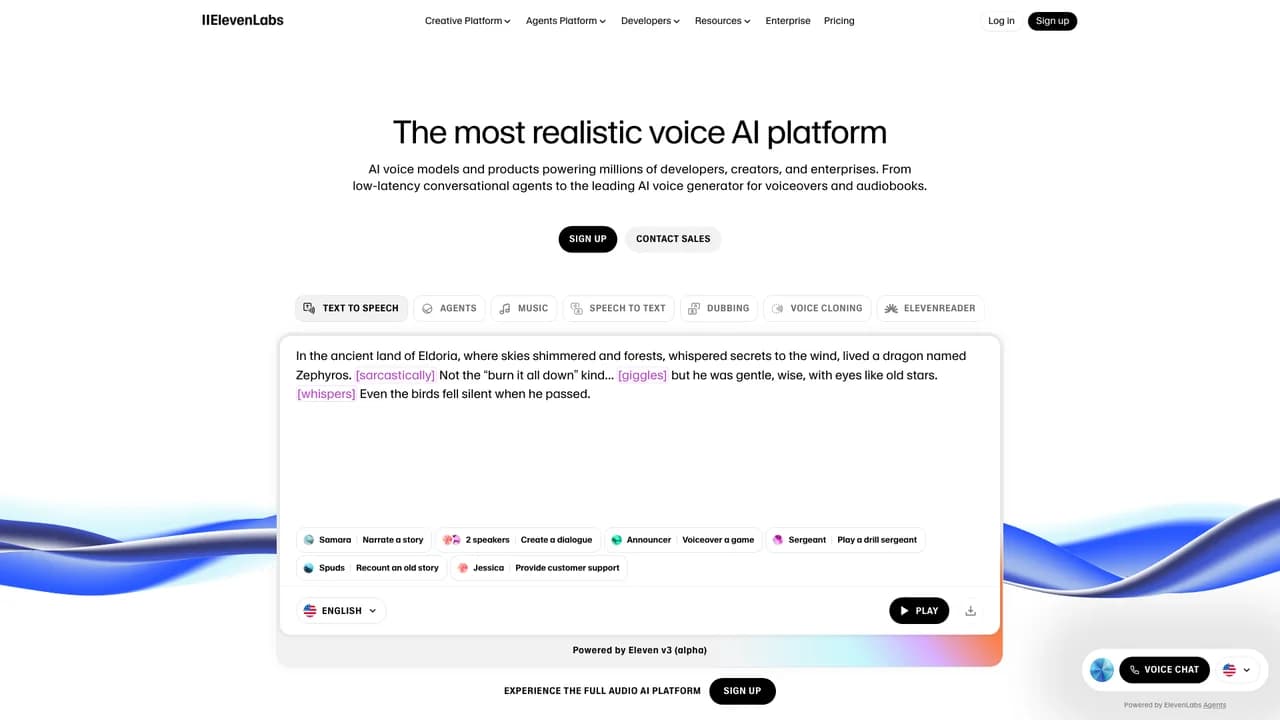
A ElevenLabs é uma empresa líder em tecnologia de áudio com IA, focada na criação de vozes sintéticas altamente realistas e expressivas emocionalmente. A plataforma oferece suporte a conversão de texto em fala, reconhecimento de voz, conversão de voz e dublagem multilíngue em mais de 30 idiomas. Utilizando modelos de aprendizado profundo, a ElevenLabs proporciona entonação, ritmo e nuance emocional naturais, sendo ideal para aplicações como narração de audiolivros e agentes de voz com IA para conversas. Comprometida com o uso responsável da IA, a empresa oferece soluções escaláveis para indivíduos, criadores de conteúdo e empresas.
Principais recursos do elevenlabs?
Preços
Nível Gratuito: Experimente ElevenLabs com um teste gratuito limitado.
Planos de Assinatura: Os planos de assinatura começam com um preço competitivo, oferecendo acesso a recursos e vozes adicionais.
Aviso Legal: Observe que as informações de preços podem não estar atualizadas. Para obter detalhes de preços mais precisos e atuais, consulte o site oficial da ElevenLabs.
Alternativas ao elevenlabs

f5-tts
O F5-TTS é uma plataforma de síntese de texto para fala (TTS) de IA de ponta que converte texto em fala altamente natural e expressiva em tempo real. O sistema emprega uma arquitetura totalmente não autorregressiva baseada em Flow Matching, combinada com Diffusion Transformer (DiT) e ConvNeXt V2, para alcançar um alinhamento superior entre texto e fala. Ele suporta clonagem de voz zero-shot a partir de amostras de áudio mínimas, síntese multilíngue — especialmente em chinês e inglês — e controle refinado sobre a emoção e a velocidade da fala. Treinado em conjuntos de dados multilíngues de grande escala, o F5-TTS atinge níveis de naturalidade e robustez líderes do setor, tornando-o adequado para diversas aplicações, como audiolivros, assistentes virtuais, criação de conteúdo e ferramentas de acessibilidade. Como um projeto de código aberto, ele incentiva a colaboração e a integração por desenvolvedores.

wavel-ai
A Wavel AI é uma plataforma abrangente com tecnologia de IA para criação de conteúdo de áudio e vídeo, que suporta conversão de texto em fala natural, clonagem de voz, transcrição de áudio e vídeo e dublagem de vídeos em múltiplos idiomas. Ela permite a geração de fala em mais de 40 idiomas e a transcrição e tradução em mais de 100 idiomas, oferecendo alta precisão e extensas opções de personalização, como ajuste de tom, emoção e sotaque. Projetada para criadores de conteúdo, empresas, educadores e desenvolvedores, a Wavel AI aprimora a acessibilidade, a localização e a distribuição global de conteúdo multimídia.

voicemaker
O Voicemaker é uma ferramenta online avançada de TTS que converte texto em fala de alta qualidade e realista. Compatível com vários idiomas e sotaques, é adequada para uma ampla gama de aplicações, como vídeos, audiolivros, educação online e atendimento ao cliente. A plataforma oferece recursos personalizáveis, incluindo velocidade, tom e volume da fala, além de pausas e efeitos sonoros, permitindo que os usuários criem conteúdo de áudio personalizado. Com uma interface intuitiva e suporte a API, é ideal para criadores de conteúdo, empresas e desenvolvedores. O áudio gerado vem com direitos de uso.

listnr-ai
O Listnr AI é um software líder em conversão de texto para fala que gera de forma eficiente locuções e conteúdos de áudio de som natural. A plataforma oferece suporte a mais de 1.000 vozes em 142 idiomas, permitindo que os usuários criem facilmente áudio de som natural para podcasts, ensino online, narração de vídeos, audiolivros e mais. Ele oferece amplas opções de personalização, incluindo estilo de voz, emoção, tom e velocidade de fala, juntamente com uma API para integração perfeita em diversos aplicativos e serviços. O Listnr AI simplifica a criação de conteúdo de áudio, tornando-a acessível e fácil de usar para criadores de conteúdo, educadores, empresas e desenvolvedores.

texttovoiceonline
O Texttovoice.online permite que os usuários convertam texto escrito em áudio de fala realista e envolvente de forma rápida e fácil. Ele oferece suporte a uma ampla gama de idiomas e opções de voz, incluindo clonagem de voz avançada e estilos de voz emocionais para aumentar a expressividade. A plataforma foi desenvolvida para criadores de conteúdo, educadores e profissionais que precisam de narrações de alta qualidade para vídeos, podcasts, audiobooks e aplicações interativas. Os usuários podem personalizar as características da voz e exportar o áudio em formatos comuns como MP3 e WAV, agilizando o processo de produção de conteúdo em áudio sem a necessidade de equipamentos de gravação.

speechki
O Speechki é uma solução abrangente de conversão de texto em voz que permite aos usuários transformar conteúdo escrito em áudio altamente realista, utilizando uma extensa biblioteca de vozes e idiomas. A plataforma conta com um editor visual intuitivo para ajustar tom, velocidade e entonação, juntamente com ferramentas avançadas para controle de prosódia e fonemas. Com suporte à formatação por capítulos, escuta de prova em tempo real e clonagem de voz, o Speechki é adequado para uma ampla gama de aplicações, incluindo aprendizagem online, produção de podcasts e distribuição global de conteúdo. Suas capacidades de integração intuitiva permitem que os usuários compartilhem e distribuam áudio facilmente em várias plataformas.


