
月間訪問数
2.9K
平均滞在時間
0 min
カテゴリー順位
#4768
直帰率
0.4%
ttsvox とは?
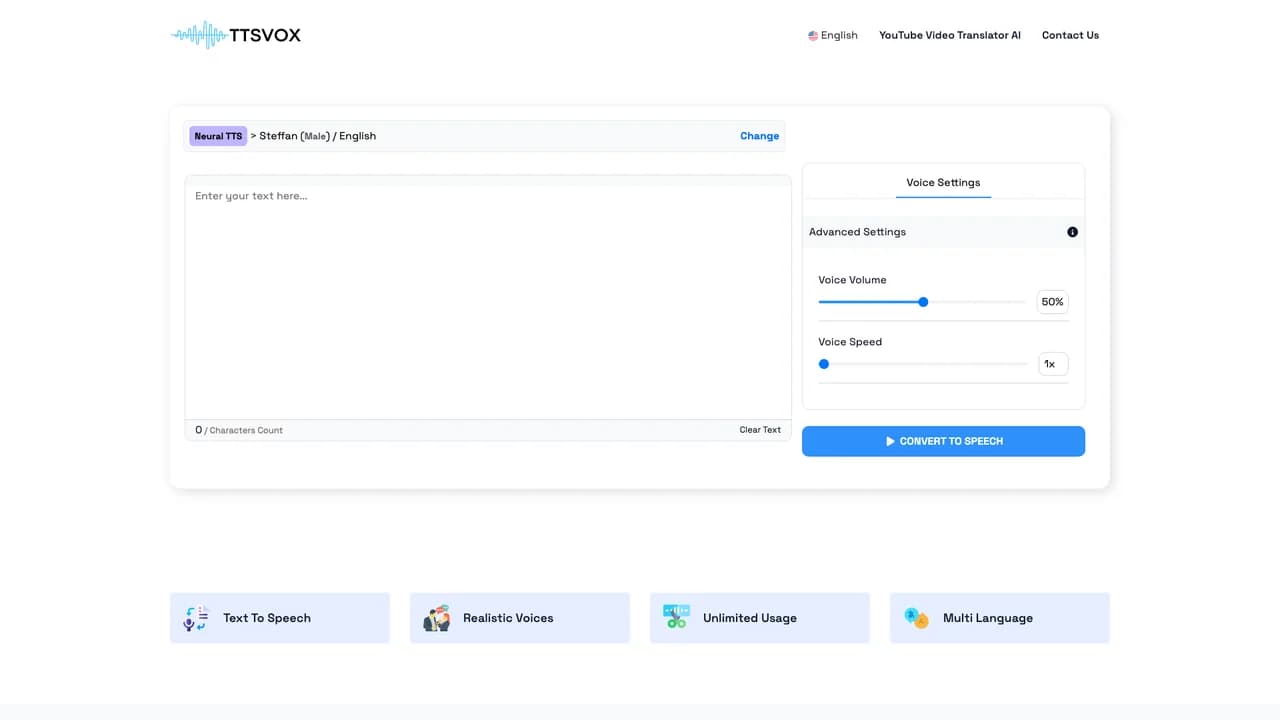
TTSVoxは、ウェブベースのテキスト読み上げプラットフォームであり、任意のテキストを自然で高品質な音声に変換できます。50以上の言語と200以上の音声オプション(さまざまなアクセントや性別を含む)をサポートしており、ユーザーはニーズに応じて音声出力をカスタマイズ可能です。TTSVoxはアクセシビリティと幅広い用途を重視して設計されており、ビデオのナレーション、オンライン教育、IVRシステム、音声付き記事など、さまざまな用途に適しています。利用回数に制限はなく、ダウンロードやインストールも不要のため、学生やビジネスパーソン、コンテンツ制作者がいつでも簡単に利用できます。
ttsvox の主な機能?
ttsvox の代替ツール

lang-lang-dubbing
琅琅配音は、書かれたテキストを中国語、英語、ドイツ語、フランス語、イタリア語、スペイン語、インドネシア語を含む30種類以上の言語で自然な音声に変換できる総合的なテキスト読み上げプラットフォームです。200種類以上の音声モデルを備え、喜び、悲しみ、興奮、恐怖など、多様な感情表現が可能です。SSMLタグによる精密な音声制御、複数人物の音声合成、背景音楽の統合、効果音の挿入といった高度な機能もサポートしています。ユーザーは高品質な商用利用可能な音声コンテンツを生成でき、著作権を完全に保有するため、ビデオナレーション、オーディオブック制作、広告、教育コンテンツなど幅広い用途に適しています。

yueyin-voice-synthesis
悦音配音はZhipianbangが開発した総合音声生成プラットフォームで、テキストを自然で滑らかな音声に変換できます。豊富な音声ライブラリを備えており、さまざまな性別や年齢層の声に対応し、標準語や各地の方言、複数の国際言語もサポートしています。動画のナレーションから教育コンテンツまで、多様な創作ニーズに対応可能です。自動音声合成とプロフェッショナルな人工音声サービスを組み合わせており、品質と予算に応じて柔軟に選択できます。

ciniao-voice
刺鸟配音は、最先端の音声合成技術を活用してテキストを自然で滑らかな音声に変換する総合的なテキスト読み上げプラットフォームです。同プラットフォームには200種類以上の多様な音声が用意されており、Magic YunxiやMagic Xiduといった人気の音声も含まれます。中国語標準語、英語、広東語、四川語、東北語、湖南語、台湾語など、複数の言語および方言に対応しています。ユーザーは読み上げ速度、ピッチ、音量、さらに背景音楽も自由にカスタマイズでき、プロフェッショナルな品質の音声コンテンツを簡単に作成可能です。短編動画、映画・テレビ番組の吹き替え、教育用コンテンツ、オーディオブックなど、幅広い用途に活用されています。

sesame-ai
Sesame AIは、高度に自然で擬人化された音声合成を実現する先進的な対話型音声モデルです。従来のテキスト読み上げシステムとは異なり、Sesameモデルはテキストと音声のコンテキストを統合し、感情やイントネーション、会話の動的な流れを正確に再現する、滑らかで表現力豊かな音声を生成します。大規模なTransformerアーキテクチャを基盤としており、多言語対応、複数の音声スタイル、リアルタイム生成および高度なカスタマイズが可能です。Sesame AIは、開発者やコンテンツ制作者、企業がリアルで自然な音声インタラクション体験を構築するのに最適です。

typecast-ai
Typecast AIは、テキストをリアルな音声に変換し、イントネーション、高低、スピード、感情をきめ細かく制御できる高度なAI音声生成プラットフォームです。独自のSpeech Synthesis Foundation Model(SSFM)を基盤として、20以上の言語で自然で表現豊かな音声を生成できます。また、プラットフォームには550人以上のAI音声アーティストとバーチャルアバターが用意されており、従来の吹き替え用レコーディングスタジオを必要とせずに、効率的にオーディオおよびビデオコンテンツを制作することが可能です。直感的なインターフェースと統合機能により、コンテンツ制作者、教育者、マーケター、開発者の業務プロセスを簡素化します。

speechgen
SpeechGenはAIを駆使したプラットフォームで、テキストを自然で滑らかな音声に変換し、高品質なナレーション(MP3またはWAV形式)を提供します。最先端のAI技術を活用して人間の発音パターンを再現し、さまざまなアクセントやスタイルの音声を選択可能です。SpeechGenは、動画制作、オンライン教育、ポッドキャストなど、多様な用途に適しています。


