
elevenlabs
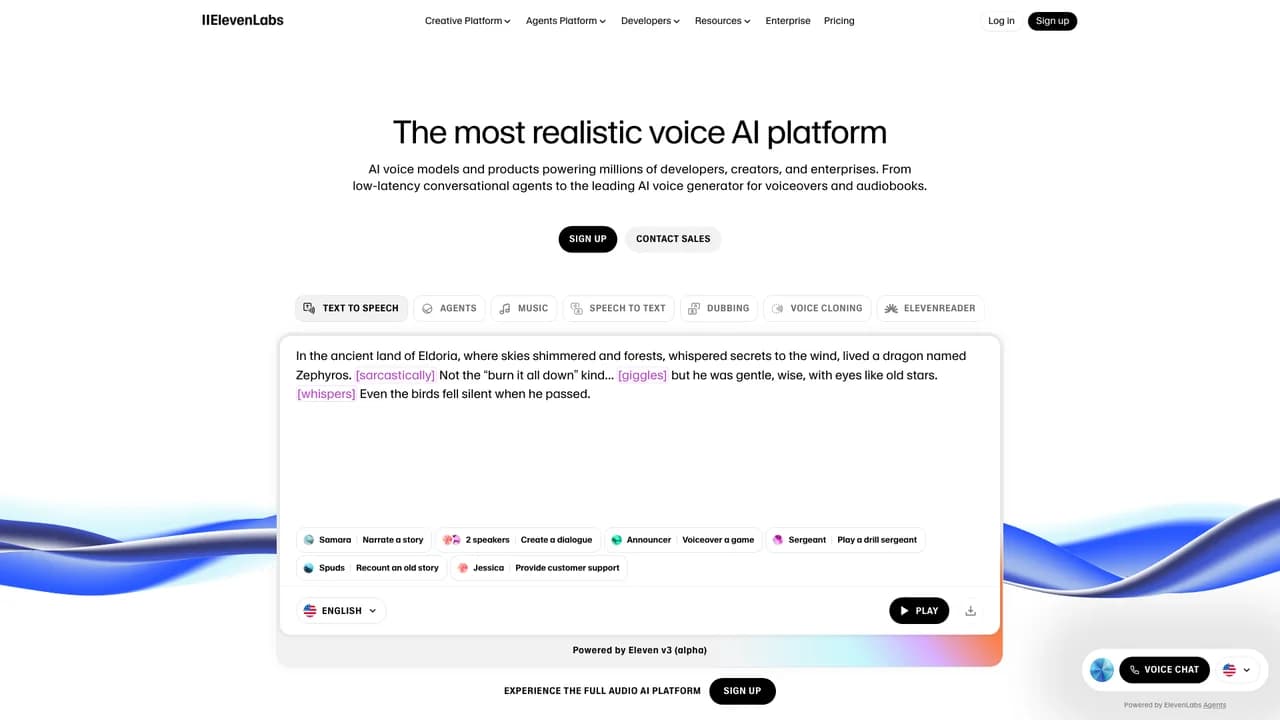
Piattaforma di sintesi vocale che genera voci multilingue naturali e supporta la conversione della voce.
Visite Mensili
22.5M
Durata Media
5 min
Posizione Categoria
#38
Frequenza di Rimbalzo
0.4%
Cos'è elevenlabs?
ElevenLabs è una società leader nel settore delle tecnologie audio basate sull'IA, focalizzata sulla creazione di voci sintetiche altamente realistiche ed emotivamente espressive. La piattaforma supporta la sintesi vocale da testo, il riconoscimento vocale, la conversione della voce e il doppiaggio multilingue in oltre 30 lingue. Sfruttando modelli di apprendimento profondo, ElevenLabs fornisce un'intonazione, un ritmo e una sfumatura emotiva naturali, rendendolo ideale per applicazioni come la narrazione di audiolibri e agenti vocali AI per conversazioni. Impegnata nell'uso responsabile dell'IA, l'azienda fornisce soluzioni scalabili per privati, creatori di contenuti ed aziende.
Funzionalità chiave di elevenlabs?
Prezzi
Livello Gratuito: Prova ElevenLabs con una prova gratuita limitata.
Piani di Abbonamento: I piani di abbonamento partono da un prezzo competitivo, offrendo accesso a funzionalità e voci aggiuntive.
Disclaimer: Si prega di notare che le informazioni sui prezzi potrebbero non essere aggiornate. Per i dettagli sui prezzi più accurati e aggiornati, fare riferimento al sito Web ufficiale di ElevenLabs.
Alternative a elevenlabs

f5-tts
F5-TTS è una piattaforma all’avanguardia di sintesi vocale AI che converte il testo in un parlato altamente naturale ed espressivo in tempo reale. Il sistema utilizza un'architettura completamente non autoregressiva basata su Flow Matching, combinata con Diffusion Transformer (DiT) e ConvNeXt V2, per ottenere un allineamento superiore tra testo e parlato. Supporta la clonazione vocale zero-shot da campioni audio minimi, la sintesi multilingue — in particolare in cinese e inglese — e un controllo granulare su emozione e velocità di eloquio. Addestrato su dataset multilingue su larga scala, F5-TTS raggiunge livelli di naturalezza e robustezza all’avanguardia nel settore, rendendolo adatto a svariate applicazioni come audiolibri, assistenti virtuali, creazione di contenuti e strumenti per l'accessibilità. In quanto progetto open-source, incoraggia la collaborazione e l'integrazione da parte degli sviluppatori.

wavel-ai
Wavel AI è una piattaforma completa basata su Intelligenza Artificiale per la creazione di contenuti audio e video, che supporta conversione da testo a voce naturale, clonazione vocale, trascrizione audio-video e doppiaggio video multilingue. Consente la generazione vocale in oltre 40 lingue e la trascrizione e traduzione in più di 100 lingue, offrendo elevata precisione e ampie opzioni di personalizzazione come regolazione di tono, emozione e accento. Progettata per creatori di contenuti, aziende, educatori e sviluppatori, Wavel AI migliora l'accessibilità, la localizzazione e la distribuzione globale di contenuti multimediali.

voicemaker
Voicemaker è uno strumento TTS online avanzato che converte il testo in parlato di alta qualità e realistico. Supportando più lingue e accenti, è adatto a una vasta gamma di applicazioni come video, audiolibri, formazione online e servizio clienti. La piattaforma offre funzionalità personalizzabili, tra cui velocità, tonalità, volume, pause ed effetti audio, permettendo agli utenti di creare contenuti audio personalizzati. Grazie a un'interfaccia intuitiva e al supporto API, è ideale per creator di contenuti, aziende e sviluppatori. L'audio generato è corredato da diritti d'uso.

listnr-ai
Listnr AI è un software di sintesi vocale all'avanguardia che genera in modo efficiente voci fuori campo e contenuti audio realistici. La piattaforma supporta oltre 1.000 voci in 142 lingue, consentendo agli utenti di creare facilmente audio dal suono naturale per podcast, formazione online, narrazione video, audiolibri e altro ancora. Offre ampie opzioni di personalizzazione, tra cui stile vocale, emozione, tono e velocità di parlato, unitamente a un'API per un'integrazione senza soluzione di continuità in varie applicazioni e servizi. Listnr AI semplifica la creazione di contenuti audio, rendendola accessibile e intuitiva per creatori di contenuti, educatori, aziende e sviluppatori.

texttovoiceonline
Texttovoice.online consente agli utenti di convertire testo scritto in audio vocale realistico e coinvolgente in modo rapido e semplice. Supporta un'ampia gamma di lingue e opzioni vocali, incluse funzioni avanzate di clonazione vocale e stili vocali emotivi per migliorare l'espressività. La piattaforma è progettata per creator di contenuti, educatori e professionisti che necessitano di voiceover di alta qualità per video, podcast, audiolibri e applicazioni interattive. Gli utenti possono personalizzare le caratteristiche vocali ed esportare l'audio in formati comuni come MP3 e WAV, semplificando il processo di produzione di contenuti vocali senza la necessità di apparecchiature di registrazione.

speechki
Speechki è una soluzione completa di sintesi vocale che consente agli utenti di convertire contenuti scritti in audio altamente realistico utilizzando un'estensa libreria di voci e lingue. La piattaforma è caratterizzata da un editor visivo intuitivo per regolare tono, velocità e altezza, insieme a strumenti avanzati per il controllo della prosodia e dei fonemi. Con il supporto per formattazione basata su capitoli, ascolto di prova in tempo reale e clonazione vocale, Speechki è adatto a un'ampia gamma di applicazioni, inclusi l'apprendimento online, la produzione di podcast e la distribuzione globale di contenuti. Le sue capacità di integrazione senza soluzione di continuità permettono agli utenti di condividere e distribuire facilmente l'audio su varie piattaforme.