
ttsvox
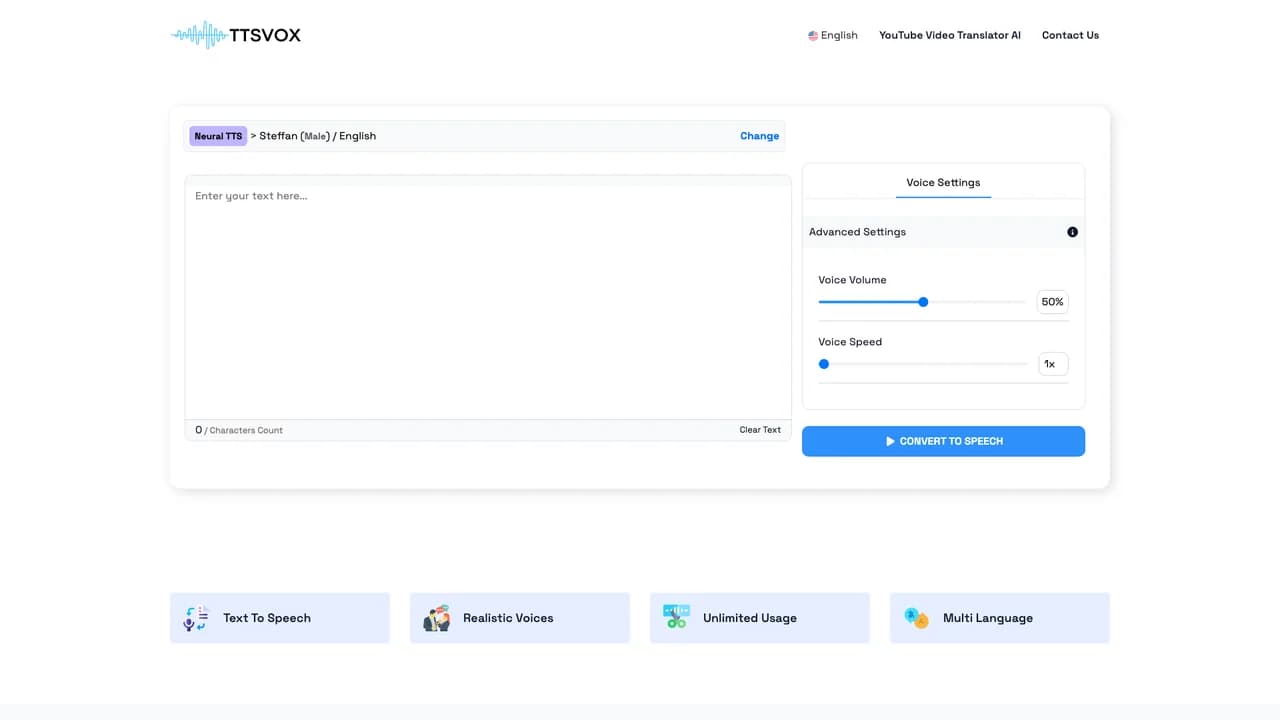
Una piattaforma web di sintesi vocale che supporta 50+ lingue e 200+ opzioni vocali per convertire testo in audio.
Visite Mensili
2.9K
Durata Media
0 min
Posizione Categoria
#4768
Frequenza di Rimbalzo
0.4%
Cos'è ttsvox?
TTSVox è una piattaforma web di sintesi vocale che converte qualsiasi testo in audio naturale e di alta qualità. Supportando oltre 50 lingue e 200 opzioni vocali—incluse vari accenti e generi—gli utenti possono personalizzare l'output vocale in base alle proprie esigenze. Progettata pensando all'accessibilità e all'ampia applicabilità, TTSVox è ideale per applicazioni come narrazione video, formazione online, sistemi IVR e articoli audio. Il servizio è disponibile per un uso illimitato senza necessità di download o installazioni, risultando comodo per studenti, professionisti e creatori di contenuti da utilizzare in qualsiasi momento.
Funzionalità chiave di ttsvox?
Alternative a ttsvox

lang-lang-dubbing
Langlang AI Voice è una piattaforma completa di sintesi vocale che converte testo scritto in parlato naturale in oltre 30 lingue, tra cui cinese, inglese, tedesco, francese, italiano, spagnolo e indonesiano. La piattaforma offre oltre 200 modelli vocali con un'ampia gamma di stili emotivi, dalla felicità e tristezza all'entusiasmo e alla paura. Supporta funzionalità avanzate come tag SSML per un controllo preciso del parlato, narrazione multi-speaker, integrazione di musica di sottofondo ed effetti sonori. Gli utenti possono generare audio di alta qualità adatto all'uso commerciale e conservare la piena proprietà dei diritti d'autore, rendendolo ideale per doppiaggio video, produzione audiolibri, pubblicità e contenuti educativi.

yueyin-voice-synthesis
Yueyin Peiyin è una completa piattaforma di generazione vocale sviluppata da Zhipianbang che converte il testo in un parlato naturale e fluido. La piattaforma vanta un'ampia libreria vocale con un'ampia gamma di voci per diversi generi e fasce d'età, supportando il mandarino, vari dialetti regionali e numerose lingue internazionali per soddisfare esigenze creative diversificate, dalla narrazione video ai contenuti educativi. Combinando la sintesi vocale automatizzata con servizi di doppiaggio umano professionale, Yueyin Peiyin offre soluzioni flessibili adattate a diverse esigenze qualitative e vincoli di budget.

ciniao-voice
Ciniao Voice è una piattaforma completa di sintesi vocale che sfrutta una tecnologia avanzata di sintesi del parlato per convertire contenuti scritti in audio naturale e fluido. La piattaforma offre oltre 200 opzioni di voce diverse, incluse voci popolari come Magic Yunxi e Magic Xidu, e supporta più lingue e dialetti tra cui mandarino, inglese, cantonese, dialetto del Sichuan, cinese della Cina nordorientale, dialetto dello Hunan e taiwanese. Gli utenti possono personalizzare la velocità del parlato, il tono, il volume e la musica di sottofondo per creare facilmente contenuti audio di livello professionale, ampiamente applicabili in scenari quali video brevi, doppiaggio cinematografico e televisivo, materiali didattici e audiolibri.

sesame-ai
Sesame AI è un modello vocale conversazionale avanzato in grado di generare una sintesi vocale altamente naturale e simile a quella umana. A differenza dei tradizionali sistemi di sintesi da testo, il modello Sesame integra sia il contesto testuale che quello audio per produrre un parlato fluido ed espressivo che cattura con precisione emozione, intonazione e dinamiche conversazionali. Basato su un'architettura Transformer su larga scala, supporta output multilingue e multi-voce con generazione in tempo reale ed elevata personalizzabilità. Sesame AI è ideale per sviluppatori, creatori di contenuti e aziende che mirano a creare esperienze di interazione vocale autentiche e naturali.

typecast-ai
Typecast AI è una piattaforma avanzata di generazione vocale AI che converte il testo in parlato realistico con un controllo preciso su tono, intonazione, velocità ed emozione. Basata sul suo modello proprietario di sintesi vocale (Speech Synthesis Foundation Model - SSFM), Typecast produce un parlato naturale ed espressivo in oltre 20 lingue. La piattaforma offre accesso a più di 550 doppiatori e avatar virtuali AI, consentendo agli utenti di produrre in modo efficiente contenuti audio e video senza la necessità di tradizionali studi di registrazione vocale. Con un'interfaccia intuitiva e capacità di integrazione senza interruzioni, Typecast semplifica i flussi di lavoro per creatori di contenuti, educatori, marketer e sviluppatori.

speechgen
SpeechGen è una piattaforma basata sull'intelligenza artificiale che converte testo scritto in un parlato naturale e fluido, fornendo voiceover di alta qualità nei formati MP3 o WAV. Sfruttando una tecnologia AI avanzata per simulare modelli di eloquio umano, offre un'ampia gamma di accenti e stili vocali. SpeechGen è adatto a varie applicazioni, inclusi video, formazione online e podcast.


