AI ToolsHub
HomeCategorieCopilota di scopertaGuide e Approfondimenti
  1. Home
  2. Strumenti
  3. Apprendimento delle Lingue
  4. audeus
audeus

audeus

App di sintesi vocale che converte molteplici formati di documenti in contenuti audio con evidenziazione testo.
Apprendimento delle LingueAssistente PDFAssistente per l'IstruzioneTesto in VoceSintesi Vocale
audeus screenshot
PanoramicaAlternative

Visite Mensili

61.9K

Durata Media

2 min

Posizione Categoria

#1466

Frequenza di Rimbalzo

0.4%

Cos'è audeus?

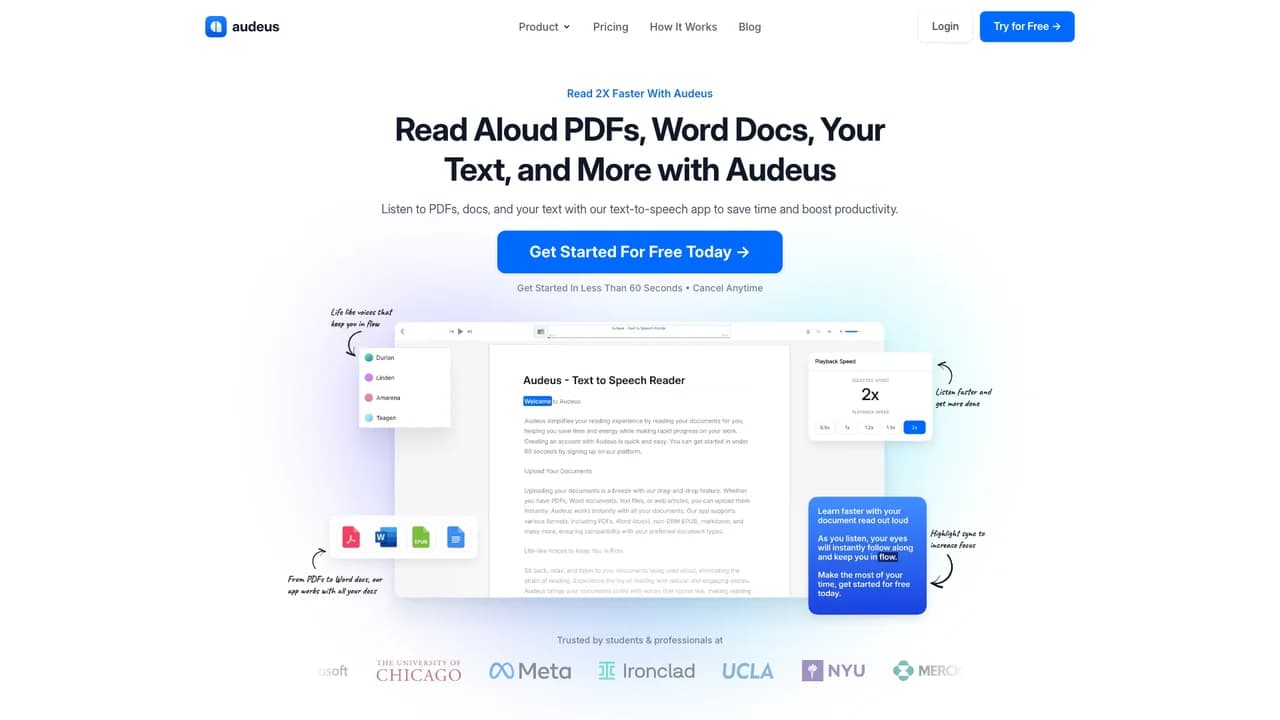
Audeus è un'applicazione di sintesi vocale (TTS) basata su cloud e alimentata dall'IA, progettata per trasformare documenti scritti in contenuti audio dinamici. Supportando molteplici formati, tra cui PDF, documenti Word, Google Docs, EPUB non protetto da DRM e pagine web, consente agli utenti di ascoltare i contenuti in qualsiasi momento e ovunque. La piattaforma utilizza voci realistiche e l'evidenziazione sincronizzata del testo per migliorare la comprensione e ridurre l'affaticamento della lettura. Audeus salva automaticamente i progressi, stima il tempo di ascolto in base alla velocità di riproduzione e offre un'utilizzo continuo su più dispositivi e browser, rendendolo ideale per studenti, professionisti e chiunque desideri migliorare l'efficienza e i risultati dell'apprendimento.

Funzionalità chiave di audeus?

Supporto multi-formato
Supporta la lettura di vari tipi di documenti tra cui PDF, documenti Word, Google Docs, pagine web e EPUB non protetto da DRM, garantendo un'ampia compatibilità.
Voce naturale e realistica
Utilizza una tecnologia vocale AI avanzata per fornire un audio realistico, migliorando l'esperienza di ascolto e la concentrazione.
Evidenziazione sincronizzata del testo
Evidenzia il testo in tempo reale durante la lettura, aiutando gli utenti a seguire e migliorare la ritenzione dei contenuti.
Tracciamento progressi e stima tempo
Salva automaticamente i progressi di lettura e stima accuratamente il tempo di ascolto in base alla velocità di riproduzione.
Integrazione multipiattaforma e browser
Funziona su più dispositivi e si integra con i browser per consentire la lettura di email, articoli e documenti in movimento.
Editor di testo personalizzato con riproduzione audio
Permette agli utenti di scrivere o modificare il testo e farselo leggere ad alta voce, facilitando la correzione di bozze e l'editing.

Alternative a audeus

ttsmp3com

ttsmp3com

ttsMP3.com è un versatile servizio online di sintesi vocale (TTS) che converte il testo scritto in voce realistica e umana, supportando oltre 28 lingue. Basato sulla tecnologia vocale AI avanzata di Amazon Polly, gli utenti possono generare audio di alta qualità in formato MP3 adatto per video, formazione online, presentazioni e applicazioni di accessibilità. La piattaforma supporta SSML (Speech Synthesis Markup Language), consentendo agli utenti di personalizzare pause, enfasi, intonazione e velocità del parlato. Con un'interfaccia intuitiva e opzioni di integrazione API, ttsMP3.com offre una soluzione professionale di voiceover ideale per creatori di contenuti, educatori, sviluppatori e aziende che cercano una produzione audio efficiente e di alta qualità.

1.2M
Corrispondenza: 80%
cloud-tts

cloud-tts

Cloud TTS è un'applicazione innovativa di sintesi vocale che consente agli utenti di convertire facilmente il testo in parlato. Supporta circa 140 lingue e presenta un'evidenziazione delle parole in stile karaoke per migliorare l'esperienza di apprendimento. La piattaforma è completamente gratuita, senza costi nascosti o limiti di utilizzo, rendendola accessibile a tutti. Gli utenti possono regolare la velocità del parlato in base alle proprie preferenze e salvare l'audio in file MP3 per l'uso offline. Pur essendo ottimizzato per Microsoft Edge su Windows, Cloud TTS è compatibile con tutti i browser e dispositivi.

21.1K
Corrispondenza: 80%
text-speechnet

text-speechnet

text-speech.net è un servizio online intuitivo di sintesi vocale che consente agli utenti di convertire facilmente qualsiasi testo scritto in audio realistico. Supporta una lunghezza illimitata del testo e permette il controllo sul ritmo del parlato, la lingua e il genere della voce. Il sistema sintetizza la voce convertendo il testo in componenti vocali che corrispondono a segmenti audio umani preregistrati, fornendo un output vocale fluido e naturale. Con un'interfaccia semplice, gli utenti devono solo inserire il testo, selezionare i parametri vocali e riprodurre istantaneamente l'audio generato.

11.5K
Corrispondenza: 80%
naturalreaders

naturalreaders

NaturalReaders è una versatile piattaforma di testo-a-vocale che converte contenuti scritti in audio naturale e fluido. Supportando oltre 200 voci IA e 50 lingue, soddisfa esigenze diverse, comprese quelle di utenti ipovedenti, individui con difficoltà di lettura e studenti di lingue. Il software include la tecnologia OCR per estrarre e leggere il testo da immagini e documenti scannerizzati, dispone di un editor di pronuncia per la personalizzazione della voce e offre un'estensione per browser per una comoda riproduzione audio delle pagine web. Con impostazioni vocali personalizzabili e capacità di esportazione audio offline, migliora l'accessibilità e le esperienze di apprendimento.

4.3M
Corrispondenza: 67%
elevenreader

elevenreader

ElevenReader è un'applicazione all'avanguardia per il text-to-speech, alimentata dall'intelligenza artificiale e sviluppata da ElevenLabs, che trasforma contenuti scritti—come eBook, PDF, pagine web e newsletter—in audio naturale ed espressivo. Con il supporto di centinaia di voci AI realistiche e 32 lingue, il prodotto offre un'esperienza di ascolto altamente personalizzabile. Gli utenti possono importare contenuti tramite vari metodi, inclusi inserimento manuale, scansione, incollaggio di URL o caricamento di file, rendendolo ideale per l'apprendimento personale, le esigenze di accessibilità e il miglioramento della produttività. Compatibile sia con dispositivi iOS che Android, ElevenReader offre un modo pratico e hands-free per ascoltare testi mentre si è in movimento.

459.7K
Corrispondenza: 67%
peech-2

peech-2

Peech è una soluzione completa di sintesi vocale che converte varie forme di contenuto scritto in esperienze audio di alta qualità. La piattaforma supporta molteplici formati di input, inclusi PDF, articoli web, eBook e libri fisici elaborati tramite tecnologia di scansione OCR. Con il supporto per oltre 60 lingue e un sistema intelligente di abbinamento vocale, Peech seleziona automaticamente la voce appropriata in base al tipo di contenuto e al contesto. Il servizio mira a migliorare l'accessibilità, la produttività e l'efficienza di apprendimento consentendo agli utenti di fruire di contenuti scritti come audio durante il multitasking o gli spostamenti.

95.2K
Corrispondenza: 67%
AI ToolsHub

Il tuo copilota per scoprire, confrontare e organizzare strumenti IA.

AI ToolsHub è un elenco di software e SaaS. Non vendiamo hardware.

Prodotto

  • Canva
  • Readdy
  • Lovart

Legale

  • Privacy Policy
  • Termini di Servizio

Azienda

  • Chi siamo
  • Contatti

In tendenza in questa categoria

lingocat

lingocat

Un'app per l'apprendimento delle lingue che pratica conversazioni quotidiane tramite giochi di ruolo e fornisce feedback su pronuncia e grammatica.

1.3K
ttsmp3com

ttsmp3com

Servizio online di sintesi vocale che converte il testo in audio MP3 multilingue con parametri vocali regolabili

1.2M
boldvoice

boldvoice

Un'app per l'allenamento della pronuncia inglese che offre percorsi personalizzati di esercizio e feedback basati sulla tua lingua madre.

612.5K
lingvanex

lingvanex

Piattaforma di traduzione multilingue che supporta la traduzione in tempo reale di testo, immagini e audio.

944.6K
migaku

migaku

Una piattaforma di apprendimento linguistico che crea flashcard annotate da contenuti autentici utilizzando la ripetizione spaziata.

579.0K
sobrief

sobrief

Una piattaforma di riassunti di libri saggistica che offre contenuti essenziali condensati in formati testuali e audio.

1.1M

Potrebbe piacerti anche

ttsmp3com

ttsmp3com

ttsMP3.com è un versatile servizio online di sintesi vocale (TTS) che converte il testo scritto in voce realistica e umana, supportando oltre 28 lingue. Basato sulla tecnologia vocale AI avanzata di Amazon Polly, gli utenti possono generare audio di alta qualità in formato MP3 adatto per video, formazione online, presentazioni e applicazioni di accessibilità. La piattaforma supporta SSML (Speech Synthesis Markup Language), consentendo agli utenti di personalizzare pause, enfasi, intonazione e velocità del parlato. Con un'interfaccia intuitiva e opzioni di integrazione API, ttsMP3.com offre una soluzione professionale di voiceover ideale per creatori di contenuti, educatori, sviluppatori e aziende che cercano una produzione audio efficiente e di alta qualità.

1.2M
cloud-tts

cloud-tts

Cloud TTS è un'applicazione innovativa di sintesi vocale che consente agli utenti di convertire facilmente il testo in parlato. Supporta circa 140 lingue e presenta un'evidenziazione delle parole in stile karaoke per migliorare l'esperienza di apprendimento. La piattaforma è completamente gratuita, senza costi nascosti o limiti di utilizzo, rendendola accessibile a tutti. Gli utenti possono regolare la velocità del parlato in base alle proprie preferenze e salvare l'audio in file MP3 per l'uso offline. Pur essendo ottimizzato per Microsoft Edge su Windows, Cloud TTS è compatibile con tutti i browser e dispositivi.

21.1K
text-speechnet

text-speechnet

text-speech.net è un servizio online intuitivo di sintesi vocale che consente agli utenti di convertire facilmente qualsiasi testo scritto in audio realistico. Supporta una lunghezza illimitata del testo e permette il controllo sul ritmo del parlato, la lingua e il genere della voce. Il sistema sintetizza la voce convertendo il testo in componenti vocali che corrispondono a segmenti audio umani preregistrati, fornendo un output vocale fluido e naturale. Con un'interfaccia semplice, gli utenti devono solo inserire il testo, selezionare i parametri vocali e riprodurre istantaneamente l'audio generato.

11.5K
naturalreaders

naturalreaders

NaturalReaders è una versatile piattaforma di testo-a-vocale che converte contenuti scritti in audio naturale e fluido. Supportando oltre 200 voci IA e 50 lingue, soddisfa esigenze diverse, comprese quelle di utenti ipovedenti, individui con difficoltà di lettura e studenti di lingue. Il software include la tecnologia OCR per estrarre e leggere il testo da immagini e documenti scannerizzati, dispone di un editor di pronuncia per la personalizzazione della voce e offre un'estensione per browser per una comoda riproduzione audio delle pagine web. Con impostazioni vocali personalizzabili e capacità di esportazione audio offline, migliora l'accessibilità e le esperienze di apprendimento.

4.3M
elevenreader

elevenreader

ElevenReader è un'applicazione all'avanguardia per il text-to-speech, alimentata dall'intelligenza artificiale e sviluppata da ElevenLabs, che trasforma contenuti scritti—come eBook, PDF, pagine web e newsletter—in audio naturale ed espressivo. Con il supporto di centinaia di voci AI realistiche e 32 lingue, il prodotto offre un'esperienza di ascolto altamente personalizzabile. Gli utenti possono importare contenuti tramite vari metodi, inclusi inserimento manuale, scansione, incollaggio di URL o caricamento di file, rendendolo ideale per l'apprendimento personale, le esigenze di accessibilità e il miglioramento della produttività. Compatibile sia con dispositivi iOS che Android, ElevenReader offre un modo pratico e hands-free per ascoltare testi mentre si è in movimento.

459.7K
peech-2

peech-2

Peech è una soluzione completa di sintesi vocale che converte varie forme di contenuto scritto in esperienze audio di alta qualità. La piattaforma supporta molteplici formati di input, inclusi PDF, articoli web, eBook e libri fisici elaborati tramite tecnologia di scansione OCR. Con il supporto per oltre 60 lingue e un sistema intelligente di abbinamento vocale, Peech seleziona automaticamente la voce appropriata in base al tipo di contenuto e al contesto. Il servizio mira a migliorare l'accessibilità, la produttività e l'efficienza di apprendimento consentendo agli utenti di fruire di contenuti scritti come audio durante il multitasking o gli spostamenti.

95.2K