
elevenlabs
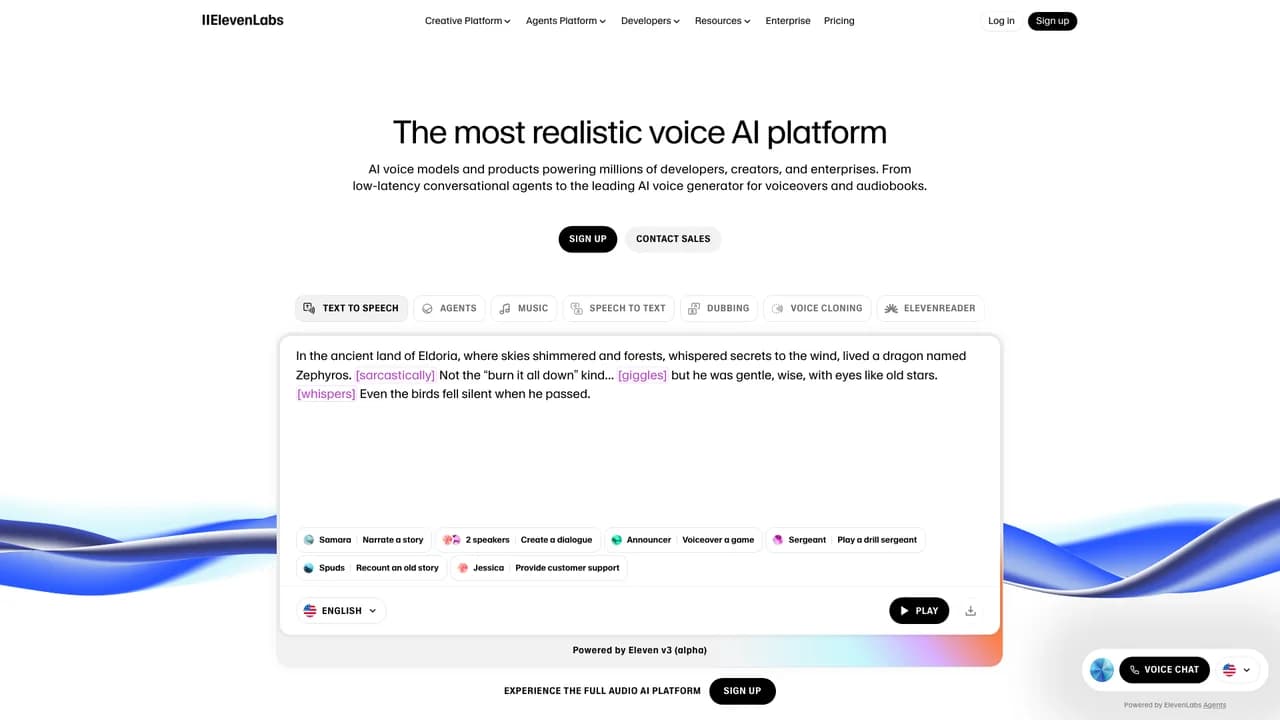
Platform teks-ke-ucapan yang menghasilkan suara multibahasa alami dan mendukung konversi suara
Kunjungan Bulanan
22.5M
Rata-rata Durasi Sesi
5 min
Peringkat Kategori
#38
Rasio Pentalan
0.4%
Apa itu elevenlabs?
ElevenLabs adalah perusahaan teknologi audio AI terkemuka yang berfokus pada pembuatan suara sintetis yang sangat realistis dan ekspresif secara emosional. Platform ini mendukung konversi teks-ke-ucapan, pengenalan ucapan, konversi suara, dan sulih suara multibahasa di lebih dari 30 bahasa. Dengan memanfaatkan model pembelajaran mendalam, ElevenLabs menghadirkan intonasi, ritme, dan nuansa emosi yang alami, sehingga ideal untuk aplikasi seperti narasi buku audio dan agen suara AI percakapan. Berkomitmen pada penggunaan AI yang bertanggung jawab, perusahaan ini menyediakan solusi yang dapat diskalakan untuk individu, kreator, dan perusahaan.
Fitur Utama elevenlabs?
Harga
Tingkat Gratis: Rasakan ElevenLabs dengan uji coba gratis terbatas.
Paket Langganan: Paket langganan dimulai dengan harga yang kompetitif, menawarkan akses ke fitur dan suara tambahan.
Pemberitahuan: Harap dicatat bahwa informasi harga mungkin tidak mutakhir. Untuk detail harga yang paling akurat dan terkini, rujuk ke situs web resmi ElevenLabs.
Alternatif untuk elevenlabs

f5-tts
F5-TTS adalah platform sintesis AI teks-ke-suara mutakhir yang mengubah teks menjadi ucapan yang sangat natural dan ekspresif secara real-time. Sistem ini menggunakan arsitektur non-autoregresif penuh berbasis Flow Matching, dikombinasikan dengan Diffusion Transformer (DiT) dan ConvNeXt V2, untuk mencapai keselarasan superior antara teks dan ucapan. Platform ini mendukung kloning suara zero-shot dari sampel audio minimal, sintesis multibahasa—khususnya dalam bahasa Tionghoa dan Inggris—serta kontrol halus atas emosi dan kecepatan bicara. Dilatih dengan dataset multibahasa berskala besar, F5-TTS mencapai tingkat naturalitas dan ketangguhan yang terdepan di industri, menjadikannya cocok untuk berbagai aplikasi seperti buku audio, asisten virtual, pembuatan konten, dan alat aksesibilitas. Sebagai proyek sumber terbuka, platform ini mendorong kolaborasi dan integrasi oleh pengembang.

wavel-ai
Wavel AI adalah platform komprehensif yang didukung AI untuk pembuatan konten audio dan video, mendukung konversi teks-ke-ucapan alami, kloning suara, transkripsi audio-video, dan sulih suara video multibahasa. Platform ini memungkinkan pembuatan ujaran dalam lebih dari 40 bahasa serta transkripsi dan terjemahan dalam lebih dari 100 bahasa, dengan menghadirkan akurasi tinggi dan beragam opsi penyesuaian seperti pengaturan pitch, emosi, dan aksen. Didesain untuk konten kreator, perusahaan, edukator, dan pengembang, Wavel AI meningkatkan aksesibilitas, pelokalan, dan distribusi global dari konten multimedia.

voicemaker
Voicemaker adalah alat TTS daring canggih yang mengubah teks menjadi ucapan berkualitas tinggi dan terdengar hidup. Mendukung banyak bahasa dan aksen, alat ini cocok untuk berbagai aplikasi seperti video, buku audio, pendidikan daring, dan layanan pelanggan. Platform ini menawarkan fitur yang dapat disesuaikan termasuk kecepatan bicara, tinggi nada, volume, jeda, dan efek audio, memungkinkan pengguna membuat konten audio yang dipersonalisasi. Dengan antarmuka yang ramah pengguna dan dukungan API, alat ini ideal untuk pembuat konten, bisnis, dan pengembang. Audio yang dihasilkan dilengkapi dengan hak penggunaan.

listnr-ai
Listnr AI adalah perangkat lunak teks-ke-suara terkemuka yang secara efisien menghasilkan narasi dan konten audio seperti suara manusia. Platform ini mendukung lebih dari 1.000 suara di 142 bahasa, memungkinkan pengguna dengan mudah membuat audio yang terdengar alami untuk podcast, pendidikan online, narasi video, buku audio, dan lainnya. Perangkat ini menawarkan berbagai opsi penyesuaian ekstensif, termasuk gaya suara, emosi, pitch, dan kecepatan bicara, dilengkapi dengan API untuk integrasi mulus ke berbagai aplikasi dan layanan. Listnr AI menyederhanakan pembuatan konten audio, membuatnya mudah diakses dan ramah pengguna bagi pembuat konten, pendidik, bisnis, dan pengembang.

texttovoiceonline
Texttovoice.online memungkinkan pengguna untuk dengan cepat dan mudah mengonversi teks tertulis menjadi suara ucapan yang realistis dan menarik. Platform ini mendukung berbagai macam pilihan bahasa dan suara, termasuk kloning suara canggih dan gaya suara emosional untuk meningkatkan ekspresi. Platform ini dirancang untuk pembuat konten, pendidik, dan profesional yang membutuhkan narasi suara berkualitas tinggi untuk video, podcast, buku audio, dan aplikasi interaktif. Pengguna dapat menyesuaikan karakteristik suara dan mengekspor audio dalam format umum seperti MP3 dan WAV, yang menyederhanakan proses produksi konten suara tanpa memerlukan peralatan perekaman.

speechki
Speechki adalah solusi komprehensif teks-ke-suara yang memungkinkan pengguna mengubah konten tertulis menjadi audio yang sangat realistis menggunakan beragam pustaka suara dan bahasa. Platform ini dilengkapi editor visual intuitif untuk menyesuaikan nada, kecepatan, dan pitch, serta alat canggih untuk kontrol prosodi dan fonem. Dengan dukungan format berbasis bab, uji dengar waktu nyata, dan kloning suara, Speechki cocok untuk berbagai aplikasi, termasuk pembelajaran daring, produksi podcast, dan distribusi konten global. Kemampuan integrasinya yang mulus memungkinkan pengguna dengan mudah berbagi dan mendistribusikan audio di berbagai platform.


