
ttsvox
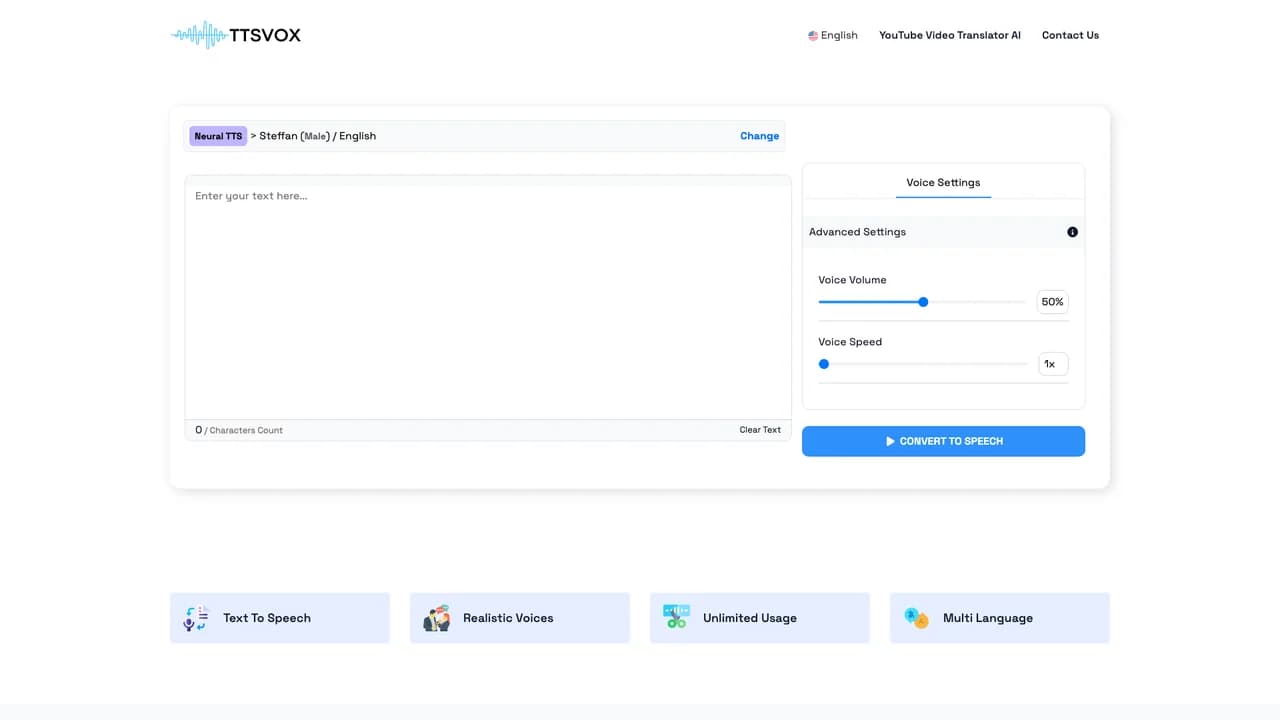
Platform teks-ke-suara berbasis web yang mendukung 50+ bahasa dan 200+ opsi suara untuk mengonversi teks menjadi audio.
Kunjungan Bulanan
2.9K
Rata-rata Durasi Sesi
0 min
Peringkat Kategori
#4768
Rasio Pentalan
0.4%
Apa itu ttsvox?
TTSVox adalah platform teks-ke-suara berbasis web yang mengonversi teks apa pun menjadi audio berkualitas tinggi dan terdengar alami. Dengan dukungan lebih dari 50 bahasa dan 200 opsi suara—termasuk berbagai aksen dan gender—pengguna dapat menyesuaikan keluaran ucapan sesuai kebutuhan mereka. Dirancang dengan mempertimbangkan aksesibilitas dan penerapan luas, TTSVox sangat ideal untuk aplikasi seperti narasi video, pendidikan online, sistem IVR, dan artikel audio. Layanan ini tersedia untuk penggunaan tanpa batas tanpa perlu unduhan atau instalasi, sehingga memudahkan pelajar, profesional, dan pembuat konten untuk menggunakannya kapan saja.
Fitur Utama ttsvox?
Alternatif untuk ttsvox

lang-lang-dubbing
Langlang AI Voice adalah platform teks-ke-ucapan komprehensif yang mengonversi teks tertulis menjadi suara yang terdengar alami dalam lebih dari 30 bahasa, termasuk Bahasa Mandarin, Inggris, Jerman, Prancis, Italia, Spanyol, dan Indonesia. Platform ini menawarkan lebih dari 200 model suara dengan beragam gaya emosi, mulai dari bahagia dan sedih hingga gembira dan takut. Platform ini mendukung fitur-fitur canggih seperti tag SSML untuk kontrol ucapan yang presisi, narasi multi-suara, integrasi musik latar, dan efek suara. Pengguna dapat menghasilkan audio berkualitas tinggi yang cocok untuk penggunaan komersial dan mempertahankan kepemilikan hak cipta penuh, menjadikannya ideal untuk sulih suara video, produksi buku audio, periklanan, dan konten edukasi.

yueyin-voice-synthesis
Yueyin Peiyin adalah platform generasi suara komprehensif yang dikembangkan oleh Zhipianbang untuk mengubah teks menjadi ucapan yang natural dan lancar. Platform ini menampilkan perpustakaan suara ekstensif dengan beragam pilihan suara dari berbagai gender dan kelompok usia, mendukung Bahasa Mandarin, berbagai dialek regional, dan beberapa bahasa internasional untuk memenuhi berbagai kebutuhan kreatif—mulai dari narasi video hingga konten edukasi. Dengan menggabungkan sintesis ucapan otomatis dan layanan pengisi suara profesional manusia, Yueyin Peiyin menawarkan solusi fleksibel yang disesuaikan dengan berbagai tingkat kualitas dan batasan anggaran.

ciniao-voice
Ciniao Voice adalah platform teks-ke-suara serba lengkap yang memanfaatkan teknologi sintesis suara canggih untuk mengubah konten tertulis menjadi audio yang alami dan lancar. Platform ini menawarkan lebih dari 200 opsi suara beragam, termasuk suara populer seperti Magic Yunxi dan Magic Xidu, serta mendukung berbagai bahasa dan dialek termasuk Mandarin, Inggris, Kanton, Sichuan, Mandarin Timur Laut, Hunan, dan Taiwan. Pengguna dapat menyesuaikan kecepatan bicara, nada, volume, dan musik latar untuk dengan mudah membuat konten audio berkualitas profesional, yang dapat diterapkan secara luas dalam skenario seperti video pendek, pengalih suaraan film dan televisi, materi pendidikan, dan buku audio.

sesame-ai
Sesame AI adalah model ucapan percakapan canggih yang mampu menghasilkan sintesis ucapan yang sangat natural dan mirip manusia. Berbeda dengan sistem teks-ke-ucap tradisional, model Sesame mengintegrasikan konteks teks dan audio untuk menghasilkan ucapan yang lancar dan ekspresif, yang secara akurat menangkap emosi, intonasi, dan dinamika percakapan. Dibangun dengan arsitektur Transformer berskala besar, model ini mendukung keluaran multibahasa dan multi-suara dengan pembangkitan waktu-nyata serta tingkat penyesuaian yang tinggi. Sesame AI sangat ideal bagi pengembang, pembuat konten, dan perusahaan yang bertujuan membangun pengalaman interaksi suara yang autentik dan natural.

typecast-ai
Typecast AI adalah platform generasi suara AI canggih yang mengubah teks menjadi ucapan realistis dengan kendali presisi atas nada, pitch, kecepatan, dan emosi. Didukung oleh Speech Synthesis Foundation Model (SSFM) proprieternya, Typecast menghadirkan ucapan yang alami dan ekspresif dalam lebih dari 20 bahasa. Platform ini menawarkan akses ke lebih dari 550 aktor suara AI dan avatar virtual, memungkinkan pengguna memproduksi konten audio dan video secara efisien tanpa memerlukan studio rekaman suara tradisional. Dengan antarmuka intuitif dan kemampuan integrasi yang mulus, Typecast menyederhanakan alur kerja bagi pembuat konten, edukator, pemasar, dan pengembang.

speechgen
SpeechGen adalah platform berbasis AI yang mengubah teks tertulis menjadi ucapan yang alami dan fasih, menghasilkan rekaman suara berkualitas tinggi dalam format MP3 atau WAV. Dengan memanfaatkan teknologi AI mutakhir untuk mensimulasikan pola bicara manusia, platform ini menawarkan beragam aksen dan gaya suara. SpeechGen cocok untuk berbagai aplikasi termasuk video, pendidikan daring, dan podcast.


