
chonkie
टोकन, शब्द, वाक्य या शब्दार्थ के आधार पर बड़े दस्तावेज़ों को विभाजित करने वाला टूल
मासिक विज़िट
19.2K
औसत सत्र अवधि
0 min
श्रेणी रैंक
N/A
बाउंस दर
0.5%
chonkie क्या है?
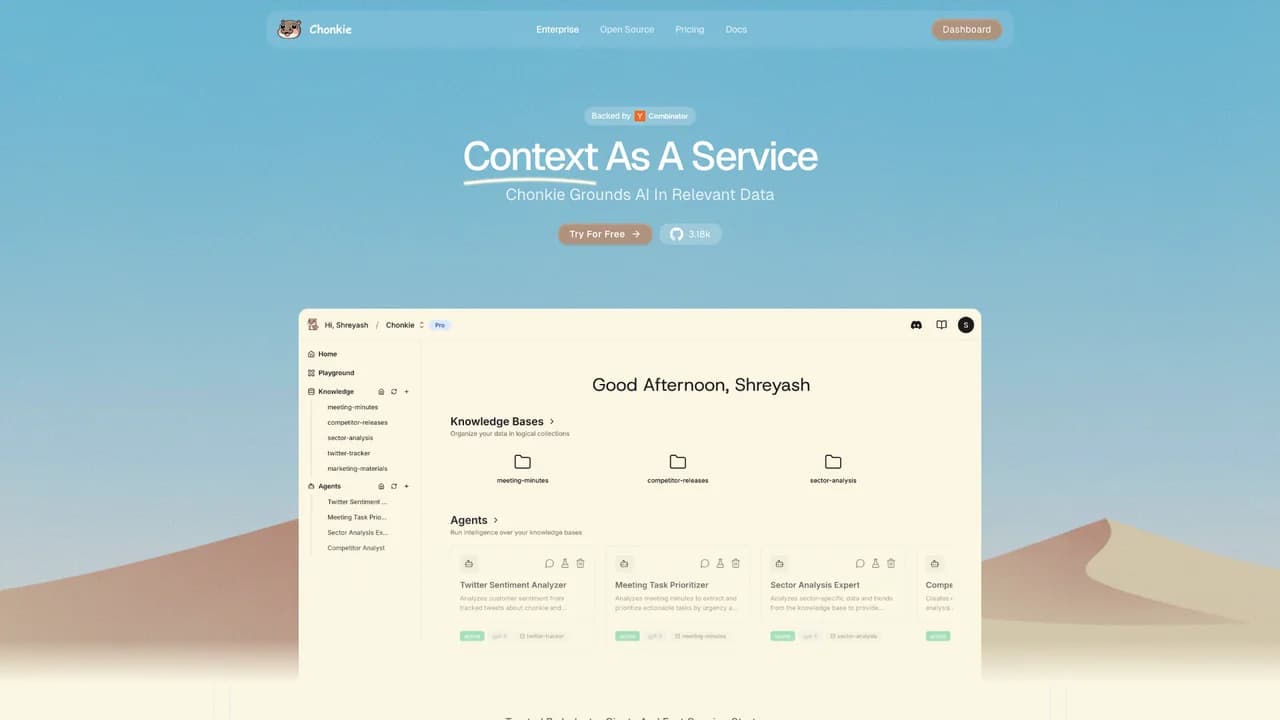
चोंकी एक ओपन-सोर्स पायथन लाइब्रेरी है जिसे रिट्रीवल-ऑगमेंटेड जेनरेशन वर्कफ़्लो के लिए बड़े, जटिल दस्तावेज़ों को अर्थपूर्ण एवं स्वतंत्र खंडों में प्रभावी ढंग से विभाजित करने के लिए डिज़ाइन किया गया है। यह टोकन-आधारित, शब्द-आधारित, वाक्य-आधारित और शब्दार्थ खंडन सहित कई खंडन रणनीतियों का समर्थन करती है, जिससे डेवलपर्स विशिष्ट एनएलपी और मशीन लर्निंग आवश्यकताओं के अनुसार पाठ विभाजन को अनुकूलित कर सकते हैं। हल्की और त्वरित स्थापना के साथ, चोंकी बड़े भाषा मॉडल के लिए प्रसंस्करण को गति देने और संदर्भ प्रबंधन को अनुकूलित करने में सहायता करती है, जिससे उपयोगकर्ता टोकन सीमाओं से पार पाकर रिट्रीवल सटीकता में सुधार कर सकते हैं।
chonkie की मुख्य विशेषताएं?
chonkie के विकल्प

deepwiki
डीपविकि स्वचालित रूप से गिटहब रिपॉजिटरीज के संपूर्ण कोडबेस, README फ़ाइलों और कॉन्फ़िगरेशन विवरणों का विश्लेषण करके व्यापक, विकिपीडिया-शैली का प्रलेखन तैयार करता है। यह जानकारी को स्पष्ट मॉड्यूल, प्रौद्योगिकी स्टैक और फ़ाइल संरचनाओं में व्यवस्थित करता है, जिसे इंटरैक्टिव आर्किटेक्चर डायग्राम द्वारा समृद्ध किया जाता है। उपयोगकर्ता एक संवादी सहायक के माध्यम से प्रलेखन के साथ बातचीत कर सकते हैं जो कोडबेस के बारे में विशिष्ट प्रश्नों के उत्तर देता है। इसके अतिरिक्त, डीपविकि एक गहन शोध मोड प्रदान करता है जो एक वरिष्ठ इंजीनियर के बराबर उन्नत अंतर्दृष्टि प्रदान करता है। सार्वजनिक रिपॉजिटरीज मुफ्त में सुलभ हैं, जबकि निजी रिपॉजिटरीज के लिए प्रमाणीकरण की आवश्यकता होती है।

notebooklm
गूगल लैब्स द्वारा विकसित और गूगल जेमिनी एआई द्वारा संचालित नोटबुकएलएम, एक उन्नत एआई-फर्स्ट नोटबुक है जिसे उपयोगकर्ताओं के दस्तावेज़ों के साथ सहभागिता के तरीके में क्रांति लाने के लिए डिज़ाइन किया गया है। पारंपरिक नोट-लेने वाले ऐप्स के विपरीत, यह आपके अपलोड किए गए सामग्री - जैसे पीडीएफ, गूगल डॉक्स, वेब पेज और स्लाइड्स - के आधार पर एक व्यक्तिगत एआई एजेंट बनाता है, जो आपके ज्ञान आधार के अनुरूप सटीक सारांशीकरण, स्पष्टीकरण और क्रॉस-डॉक्यूमेंट विश्लेषण को सक्षम बनाता है। इसमें पॉडकास्ट-शैली के ऑडियो सारांश भी शामिल हैं, जो सूचना के उपभोग को अधिक लचीला और रोचक बनाते हैं।

modal
मॉडल एआई, मशीन लर्निंग और डेटा टीमों के लिए डिज़ाइन किया गया एक क्लाउड फंक्शन प्लेटफ़ॉर्म है, जो अंतर्निहित बुनियादी ढांचे का प्रबंधन किए बिना कंप्यूट-गहन एप्लिकेशन के निष्पादन को सक्षम बनाता है। यह प्लेटफ़ॉर्म स्वचालित इलास्टिक स्केलिंग और जीपीयू समर्थन के साथ पायथन कोड के तेज़, सर्वरलेस निष्पादन का समर्थन करता है, जिससे डेवलपर्स इंफेरेंस एंडपॉइंट्स, बैच जॉब और शेड्यूल्ड कार्यों को सहजता से डिप्लॉय कर सकते हैं। मॉडल एक सहज पायथन इंटरफेस के माध्यम से कंटेनर परिवेश, हार्डवेयर आवश्यकताओं और स्थायी संग्रहण की कॉन्फ़िगरेशन जटिलता को सरल बनाता है, और केवल उपयोग किए गए वास्तविक कंप्यूट समय के लिए शुल्क लेता है। ओरेकल क्लाउड इंफ्रास्ट्रक्चर के साथ गहरे एकीकृत, यह बड़े पैमाने पर एआई वर्कलोड के लिए उच्च प्रदर्शन और लागत-दक्षता प्रदान करता है।

dataworld
डेटा.वर्ल्ड एक अभिनव क्लाउड-आधारित डेटा कैटलॉग समाधान है जो संगठनों को उनकी डेटा परिसंपत्तियों को जोड़ने, समझने और उन पर विश्वास करने में मदद करता है। यह ज्ञान ग्राफ़ आर्किटेक्चर पर निर्मित है, जो व्यापक मेटाडेटा प्रबंधन, स्वचालित डेटा समृद्धीकरण और एआई-संचालित खोज क्षमताएं प्रदान करता है। यह प्लेटफॉर्म सहज डेटा खोज, शासन और सहयोग को सक्षम बनाता है, जिससे विविध टीमें कार्रवाई योग्य अंतर्दृष्टि तक कुशलतापूर्वक और सुरक्षित रूप से पहुंच सकती हैं।

deep-lake
डीप लेक एआई और मशीन लर्निंग वर्कलोड के लिए विशेष रूप से निर्मित एक डेटा अवसंरचना समाधान है। इसका मुख्य उत्पाद, डीप लेक, एक ओपन-सोर्स, सर्वरलेस डेटाबेस है जो छवियों, वीडियो, ऑडियो और पॉइंट क्लाउड जैसे बड़े पैमाने के मल्टीमॉडल डेटासेट को संग्रहीत, संस्करण बनाने और स्ट्रीम करने के लिए अनुकूलित है। जटिल डेटा पाइपलाइनों को सरल बनाने और मशीन लर्निंग मॉडल के साथ निर्बाध एकीकरण को सक्षम करके, एक्टिवलूप शोधकर्ताओं, स्टार्टअप्स और उद्यमों के लिए एआई उत्पाद विकास को गति देता है। यह प्लेटफ़ॉर्म मल्टी-इंडेक्स पुनर्प्राप्ति, सब-सेकंड क्वेरी विलंबता और लचीले मॉडल एकीकरण का समर्थन करता है, जिससे टीमें अत्यधिक सटीक, स्केलेबल और लागत-प्रभावी एआई सिस्टम बना सकती हैं।

contextual-ai
कॉन्टेक्स्चुअल AI एक व्यापक प्लेटफ़ॉर्म प्रदान करता है जो जटिल एंटरप्राइज़ आवश्यकताओं के अनुरूप RAG एप्लिकेशन बनाने, तैनात करने और स्केल करने के लिए डिज़ाइन किया गया है। पुनर्प्राप्ति और जनन को एक एकीकृत प्रणाली के रूप में अनुकूलित करके, यह प्रमुख चुनौतियों जैसे हॅलुसिनेशन, पुराना डेटा और डेटा गोपनीयता का समाधान करता है। यह प्लेटफ़ॉर्म कई डेटा प्रकारों, एंटरप्राइज़-ग्रेड सुरक्षा और लचीले तैनाती विकल्पों का समर्थन करता है, जो संगठनों को विशाल और जटिल दस्तावेज़ों को उच्च सटीकता और नियंत्रण के साथ क्रियात्मक अंतर्दृष्टि में बदलने में सक्षम बनाता है।


