
elevenlabs
Plateforme de synthèse vocale qui génère des voix multilingues naturelles et prend en charge la conversion de voix.
Visites mensuelles
22.5M
Durée moy. session
5 min
Rang catégorie
#38
Taux de rebond
0.4%
Qu'est-ce que elevenlabs ?
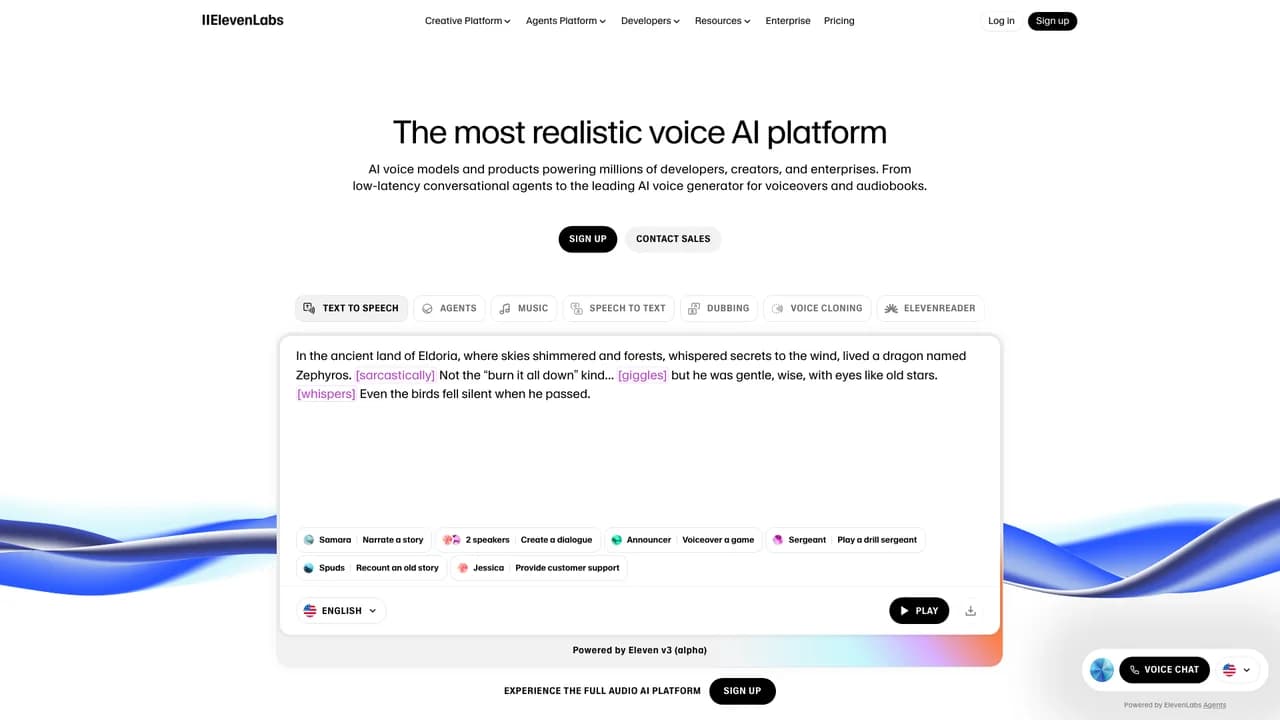
ElevenLabs est une société leader en technologie audio par IA, spécialisée dans la création de voix synthétiques hautement réalistes et expressives sur le plan émotionnel. La plateforme prend en charge la synthèse vocale, la reconnaissance vocale, la conversion de voix et le doublage multilingue dans plus de 30 langues. S'appuyant sur des modèles d'apprentissage profond, ElevenLabs offre une intonation, un rythme et des nuances émotionnelles naturels, ce qui la rend idéale pour des applications telles que la narration de livres audio et les agents conversationnels vocaux avec IA. Fidèle à une utilisation responsable de l'IA, la société propose des solutions évolutives pour les particuliers, les créateurs et les entreprises.
Fonctionnalités clés de elevenlabs?
Tarifs
Niveau Gratuit : Découvrez ElevenLabs avec un essai gratuit limité.
Plans d'Abonnement : Les plans d'abonnement commencent à un prix compétitif, offrant un accès à des fonctionnalités et des voix supplémentaires.
Avis de non-responsabilité : Veuillez noter que les informations tarifaires peuvent ne pas être à jour. Pour obtenir les détails de tarification les plus précis et les plus récents, consultez le site Web officiel d'ElevenLabs.
Alternatives à elevenlabs

f5-tts
F5-TTS est une plateforme de synthèse vocale IA de pointe qui convertit du texte en parole hautement naturelle et expressive en temps réel. Le système utilise une architecture totalement non-autorégressive basée sur le Flow Matching, combinée à Diffusion Transformer (DiT) et ConvNeXt V2, pour obtenir une alignement supérieur entre le texte et la parole. Il prend en charge le clonage vocal zero-shot à partir d'échantillons audio minimaux, la synthèse multilingue – notamment en chinois et en anglais – et un contrôle précis de l'émotion et du débit de parole. Entraîné sur des ensembles de données multilingues à grande échelle, F5-TTS atteint des niveaux inégalés dans l'industrie en termes de naturel et de robustesse, ce qui le rend adapté à diverses applications telles que les livres audio, les assistants virtuels, la création de contenu et les outils d'accessibilité. En tant que projet open-source, il encourage la collaboration et l'intégration par les développeurs.

wavel-ai
Wavel AI est une plateforme complète, alimentée par l'IA, pour la création de contenu audio et vidéo, prenant en charge la conversion de texte en parole naturelle, le clonage vocal, la transcription audio-vidéo, et le doublage vidéo multilingue. Elle permet la génération de parole dans plus de 40 langues ainsi que la transcription et la traduction dans plus de 100 langues, offrant une grande précision et des options de personnalisation étendues telles que l'ajustement de la hauteur, de l'émotion et de l'accent. Conçue pour les créateurs de contenu, les entreprises, les éducateurs et les développeurs, Wavel AI améliore l'accessibilité, la localisation et la distribution mondiale de contenu multimédia.

voicemaker
Voicemaker est un outil de TTS en ligne avancé qui convertit du texte en une parole naturelle et de haute qualité. Prenant en charge de multiples langues et accents, il convient à un large éventail d'applications telles que les vidéos, les livres audio, l'éducation en ligne et le service client. La plateforme propose des fonctionnalités personnalisables incluant la vitesse de parole, la tonalité, le volume, les pauses et les effets audio, permettant aux utilisateurs de créer des contenus audio personnalisés. Avec une interface conviviale et la prise en charge d'API, il est idéal pour les créateurs de contenu, les entreprises et les développeurs. Les fichiers audio générés sont accompagnés de droits d'utilisation.

listnr-ai
Listnr AI est un logiciel de synthèse vocale de premier plan qui génère efficacement des voix off et des contenus audio naturels. La plateforme prend en charge plus de 1 000 voix dans 142 langues, permettant aux utilisateurs de créer facilement des fichiers audio au son naturel pour les podcasts, l'éducation en ligne, la narration vidéo, les livres audio et plus encore. Elle propose de nombreuses options de personnalisation, notamment le style vocal, l'émotion, le ton et le débit d'élocution, ainsi qu'une API pour une intégration transparente dans diverses applications et services. Listnr AI simplifie la création de contenu audio, le rendant accessible et convivial pour les créateurs de contenu, les éducateurs, les entreprises et les développeurs.

texttovoiceonline
Texttovoice.online permet aux utilisateurs de convertir rapidement et facilement un texte écrit en une parole audio réaliste et captivante. Il prend en charge un large éventail de langues et d'options vocales, incluant le clonage vocal avancé et les styles vocaux émotionnels pour renforcer l'expressivité. La plateforme est conçue pour les créateurs de contenu, les éducateurs et les professionnels ayant besoin de voix off de haute qualité pour des vidéos, podcasts, livres audio et applications interactives. Les utilisateurs peuvent personnaliser les caractéristiques vocales et exporter l'audio dans des formats courants tels que MP3 et WAV, rationalisant ainsi le processus de production de contenu vocal sans nécessiter d'équipement d'enregistrement.

speechki
Speechki est une solution complète de synthèse vocale qui permet aux utilisateurs de convertir du contenu écrit en audio hautement réaliste grâce à une vaste bibliothèque de voix et de langues. La plateforme dispose d'un éditeur visuel intuitif pour ajuster le ton, la vitesse et la hauteur, ainsi que d'outils avancés pour le contrôle de la prosodie et des phonèmes. Avec la prise en charge du formatage par chapitres, de l'écoute de contrôle en temps réel et du clonage vocal, Speechki convient à un large éventail d'applications, y compris l'apprentissage en ligne, la production de podcasts et la diffusion de contenus à l'échelle mondiale. Ses capacités d'intégration transparente permettent aux utilisateurs de partager et de distribuer facilement l'audio sur diverses plateformes.


