
cybervoice-steosvoice
Une plateforme de synthèse vocale qui convertit du texte en plus de 400 voix multilingues au son naturel.
Visites mensuelles
55.5K
Durée moy. session
0 min
Rang catégorie
#3010
Taux de rebond
0.4%
Qu'est-ce que cybervoice-steosvoice ?
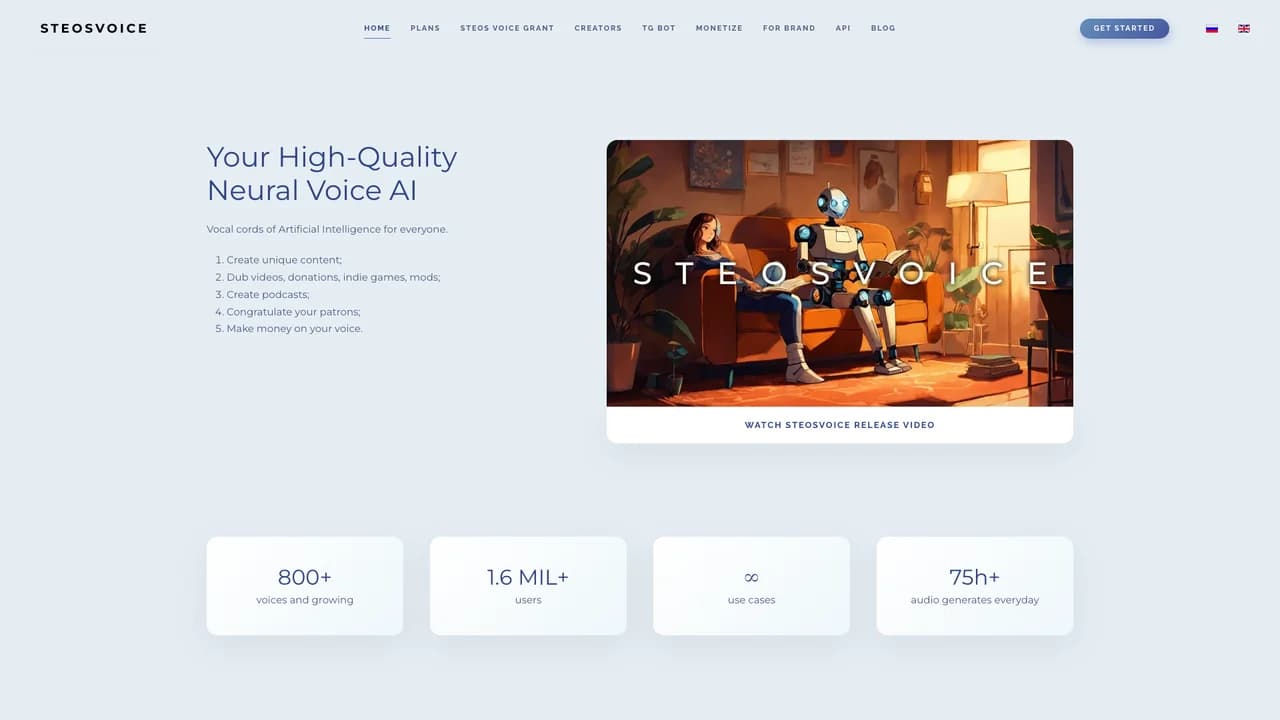
Cybervoice (maintenant commercialisé sous le nom de SteosVoice) est une plateforme de synthèse vocale par IA de pointe qui utilise une technologie avancée de réseaux neuronaux pour convertir du texte en un discours de haute qualité au son naturel. La plateforme propose plus de 400 voix uniques couvrant de multiples langues et styles, prenant en charge diverses applications telles que le doublage vidéo, les podcasts, les mods de jeux, les livres audio et la monétisation de voix. Elle fournit également un bot Telegram gratuit pour un accès et un essai faciles, ainsi que des formules d'abonnement évolutives incluant une licence commerciale. SteosVoice permet aux comédiens vocaux de concéder sous licence leurs voix et de percevoir des parts de revenus, offrant ainsi une solution complète et unique pour la production de contenu audio créatif et professionnel.
Fonctionnalités clés de cybervoice-steosvoice?
Alternatives à cybervoice-steosvoice

typecast-ai
Typecast AI est une plateforme avancée de synthèse vocale IA qui convertit du texte en une parole réaliste avec un contrôle précis du ton, de la hauteur, de la vitesse et des émotions. Propulsé par son modèle de fondation propriétaire de synthèse de la parole (Speech Synthesis Foundation Model - SSFM), Typecast délivre une parole naturelle et expressive dans plus de 20 langues. La plateforme offre un accès à plus de 550 voix IA et avatars virtuels, permettant aux utilisateurs de produire efficacement du contenu audio et vidéo sans recourir aux studios d'enregistrement vocaux traditionnels. Avec une interface intuitive et des capacités d'intégration fluide, Typecast rationalise les flux de travail pour les créateurs de contenu, les enseignants, les spécialistes du marketing et les développeurs.

unreal-speech
Unreal Speech est une plateforme de synthèse vocale de pointe, alimentée par l'IA, qui produit une synthèse vocale de haute qualité et au son naturel à un coût significativement inférieur à celui des solutions concurrentes. Elle prend en charge la diffusion audio en temps réel à ultra-faible latence et propose un large choix de langues et de voix. Conçue pour les développeurs, la plateforme propose une intégration API facile et des options de personnalisation avancées telles que la hauteur tonale, le débit d'élocution et l'émotion. Elle est idéale pour les créateurs de contenu, les éducateurs et les entreprises cherchant à améliorer l'accessibilité, l'interactivité et l'automatisation.

coefont-cloud
CoeFont CLOUD est une plateforme vocale avancée alimentée par l'IA qui permet aux utilisateurs du monde entier de générer, de personnaliser et d'appliquer des voix numériques de haute qualité dans plusieurs langues et styles. Propulsée par des algorithmes d'apprentissage profond de pointe, la plateforme offre une synthèse vocale naturelle et fluide, idéale pour un large éventail d'applications telles que le doublage vocal, les chatbots, les livres audio et les assistants virtuels. En rationalisant le processus de création vocale, CoeFont CLOUD offre aux créateurs de contenu, aux entreprises et aux développeurs une solution vocale flexible, économique et évolutive.

autocontent-api
AutoContent API est une plateforme d'IA spécialisée dans la conversion automatique de textes et de documents en podcasts et contenus audio de haute qualité. S'appuyant sur des technologies avancées de reconnaissance automatique de la parole (ASR) et de réseaux neuronaux comme les LSTM, elle prend en charge la génération et la transcription multilingue de podcasts. L'API permet une intégration fluide avec les plateformes cloud, aidant les créateurs de contenu, les enseignants et les équipes à générer, personnaliser et gérer efficacement du contenu audio à grande échelle.

text-reader-ai
Text Reader AI est une solution avancée de synthèse vocale qui convertit le contenu écrit en un audio naturel et humain en quelques secondes. Alimenté par des algorithmes d'IA et des voix WaveNet de haute qualité, il prend en charge de nombreuses langues et accents, ce qui le rend idéal pour des applications dans l'accessibilité, l'éducation, la création de contenu et l'engagement client. La plateforme permet la création de voix-off pour des podcasts, vidéos, livres audio et plus encore, avec la possibilité de télécharger les fichiers audio au format MP3 pour une diffusion facile. Doté d'une interface épurée et conviviale et d'une IA en constante amélioration, il garantit une sortie vocale réaliste et naturelle adaptée à une large gamme d'utilisations.

generador-de-voz-online-gratis
Le Générateur de Voix en Ligne Gratuit est une plateforme de synthèse vocale conviviale qui convertit du texte écrit en une parole naturelle et fluide grâce aux technologies d'apprentissage profond et de traitement automatique du langage. Il prend en charge plus de 409 voix couvrant 129 langues et dialectes, y compris des accents régionaux. La plateforme dispose d'un panneau de commande avancé permettant aux utilisateurs de régler la vitesse d'élocution, la hauteur tonale, le volume et d'ajouter des pauses respiratoires réalistes, tout en prenant en charge les balises SSML pour un contrôle précis de la sortie audio. Les utilisateurs peuvent générer un audio de jusqu'à 5 000 caractères par session et le télécharger dans des formats courants tels que MP3 et WAV, ce qui le rend adapté à la création de contenu, à l'assistance pour l'accessibilité et à diverses autres applications.


