
elevenlabs
Plataforma de texto a voz que genera voces multilingües naturales y soporta conversión de voz
Visitas Mensuales
22.5M
Duración Promedio
5 min
Ranking en Categoría
#38
Tasa de Rebote
0.4%
¿Qué es elevenlabs?
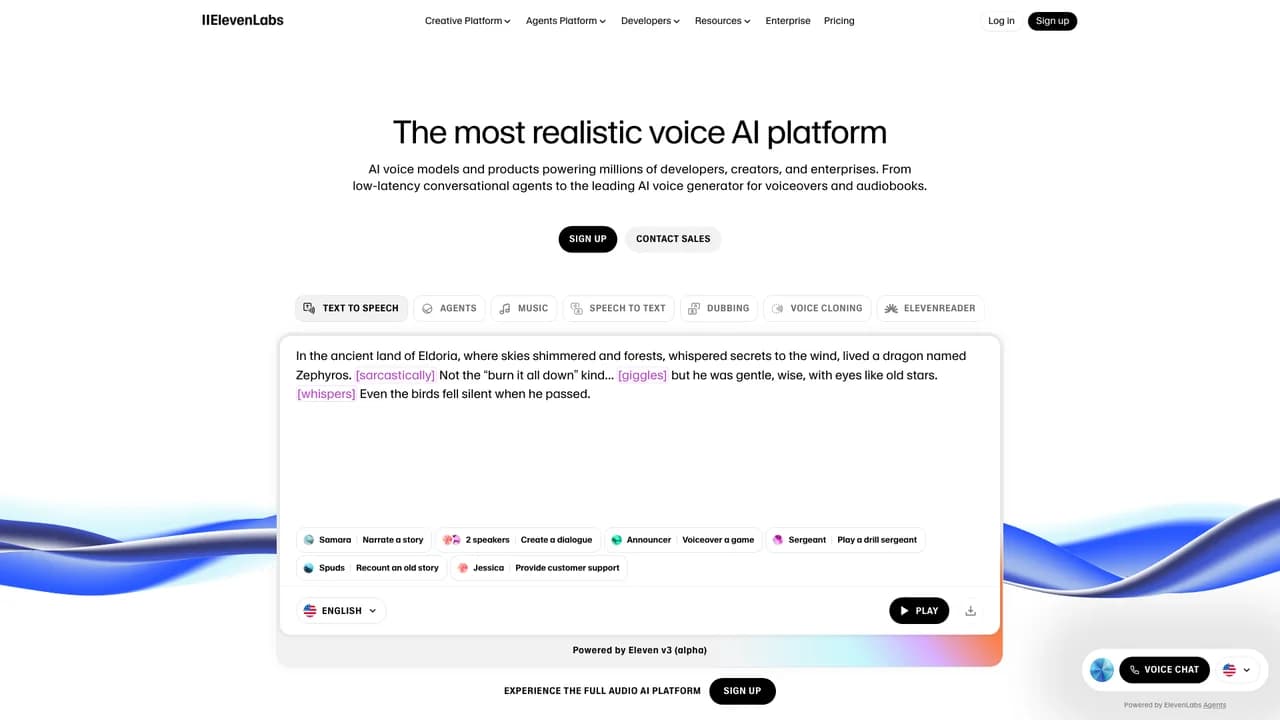
ElevenLabs es una empresa líder en tecnología de audio con IA centrada en crear voces sintéticas altamente realistas y expresivas emocionalmente. La plataforma soporta conversión de texto a voz, reconocimiento de voz, conversión de voz y doblaje multilingüe en más de 30 idiomas. Aprovechando modelos de aprendizaje profundo, ElevenLabs ofrece una entonación, ritmo y matices emocionales naturales, lo que la hace ideal para aplicaciones como narración de audiolibros y agentes de voz conversacionales con IA. Comprometida con el uso responsable de la IA, la empresa ofrece soluciones escalables para individuos, creadores y empresas.
Características clave de elevenlabs?
Precios
Nivel Gratuito: Experimenta ElevenLabs con una prueba gratuita limitada.
Planes de Suscripción: Los planes de suscripción comienzan a un precio competitivo, ofreciendo acceso a funciones y voces adicionales.
Descargo de responsabilidad: Tenga en cuenta que la información de precios puede no estar actualizada. Para obtener detalles de precios más precisos y actuales, consulte el sitio web oficial de ElevenLabs.
Alternativas a elevenlabs

f5-tts
F5-TTS es una plataforma de vanguardia de síntesis de voz por IA que convierte texto en habla altamente natural y expresiva en tiempo real. El sistema emplea una arquitectura completamente no autorregresiva basada en Flow Matching, combinada con Diffusion Transformer (DiT) y ConvNeXt V2, para lograr una alineación superior entre el texto y el habla. Soporta clonación de voz de cero disparos a partir de muestras de audio mínimas, síntesis multilingüe—especialmente en chino e inglés—y un control detallado de la emoción y la velocidad del habla. Entrenado con conjuntos de datos multilingües a gran escala, F5-TTS alcanza niveles líderes en la industria en cuanto a naturalidad y robustez, lo que lo hace apto para diversas aplicaciones como audiolibros, asistentes virtuales, creación de contenidos y herramientas de accesibilidad. Al ser un proyecto de código abierto, fomenta la colaboración e integración por parte de los desarrolladores.

wavel-ai
Wavel AI es una plataforma integral con tecnología de IA para la creación de contenido de audio y video, que admite la conversión de texto a voz natural, clonación de voz, transcripción de audio y video, y doblaje multilingüe de videos. Permite generar voz en más de 40 idiomas y realizar transcripción y traducción en más de 100 idiomas, ofreciendo alta precisión y amplias opciones de personalización, como ajustes de tono, emoción y acento. Diseñado para creadores de contenido, empresas, educadores y desarrolladores, Wavel AI mejora la accesibilidad, localización y distribución global de contenido multimedia.

voicemaker
Voicemaker es una herramienta avanzada de TTS en línea que convierte texto en voz de alta calidad y realista. Con soporte para múltiples idiomas y acentos, es adecuada para una amplia gama de aplicaciones como videos, audiolibros, educación en línea y servicio al cliente. La plataforma ofrece funciones personalizables, incluyendo velocidad de habla, tono, volumen, pausas y efectos de audio, permitiendo a los usuarios crear contenido de audio personalizado. Con una interfaz fácil de usar y soporte API, es ideal para creadores de contenido, empresas y desarrolladores. El audio generado incluye derechos de uso.

listnr-ai
Listnr AI es un software líder de conversión de texto a voz que genera eficientemente voces en off y contenido de audio de sonido humano. La plataforma admite más de 1000 voces en 142 idiomas, permitiendo a los usuarios crear fácilmente audio de sonido natural para podcasts, educación en línea, narración de videos, audiolibros y más. Ofrece amplias opciones de personalización, incluidos estilo de voz, emoción, tono y velocidad del habla, junto con una API para una integración sin inconvenientes en diversas aplicaciones y servicios. Listnr AI simplifica la creación de contenido de audio, haciéndolo accesible y fácil de usar para creadores de contenido, educadores, empresas y desarrolladores.

texttovoiceonline
Texttovoice.online permite a los usuarios convertir texto escrito en audio de voz realista y atractivo de forma rápida y sencilla. Es compatible con una amplia gama de idiomas y opciones de voz, incluidas funciones avanzadas como clonación de voz y estilos de voz emocionales para mejorar la expresividad. La plataforma está diseñada para creadores de contenido, educadores y profesionales que necesitan voces en off de alta calidad para videos, podcasts, audiolibros y aplicaciones interactivas. Los usuarios pueden personalizar las características de la voz y exportar el audio en formatos comunes como MP3 y WAV, agilizando el proceso de producción de contenido de voz sin necesidad de equipos de grabación.

speechki
Speechki es una solución integral de texto a voz que permite a los usuarios convertir contenido escrito a audio de gran realismo, utilizando una amplia biblioteca de voces e idiomas. La plataforma cuenta con un editor visual intuitivo para ajustar el tono, la velocidad y el tono, junto con herramientas avanzadas para el control de la prosodia y los fonemas. Con soporte para formato basado en capítulos, escucha de prueba en tiempo real y clonación de voz, Speechki es adecuado para una amplia gama de aplicaciones, como aprendizaje en línea, producción de podcasts y distribución global de contenido. Sus capacidades de integración sin fisuras permiten a los usuarios compartir y distribuir audio fácilmente en diversas plataformas.


