
mongodb
Dokumentendatenbank zur Speicherung von JSON-Daten mit Unterstützung für Sharding, Replikation und Echtzeitaggregation
Monatliche Besuche
6.0M
Ø Sitzungsdauer
5 min
Kategorie-Rang
#85
Absprungrate
0.3%
Was ist mongodb?
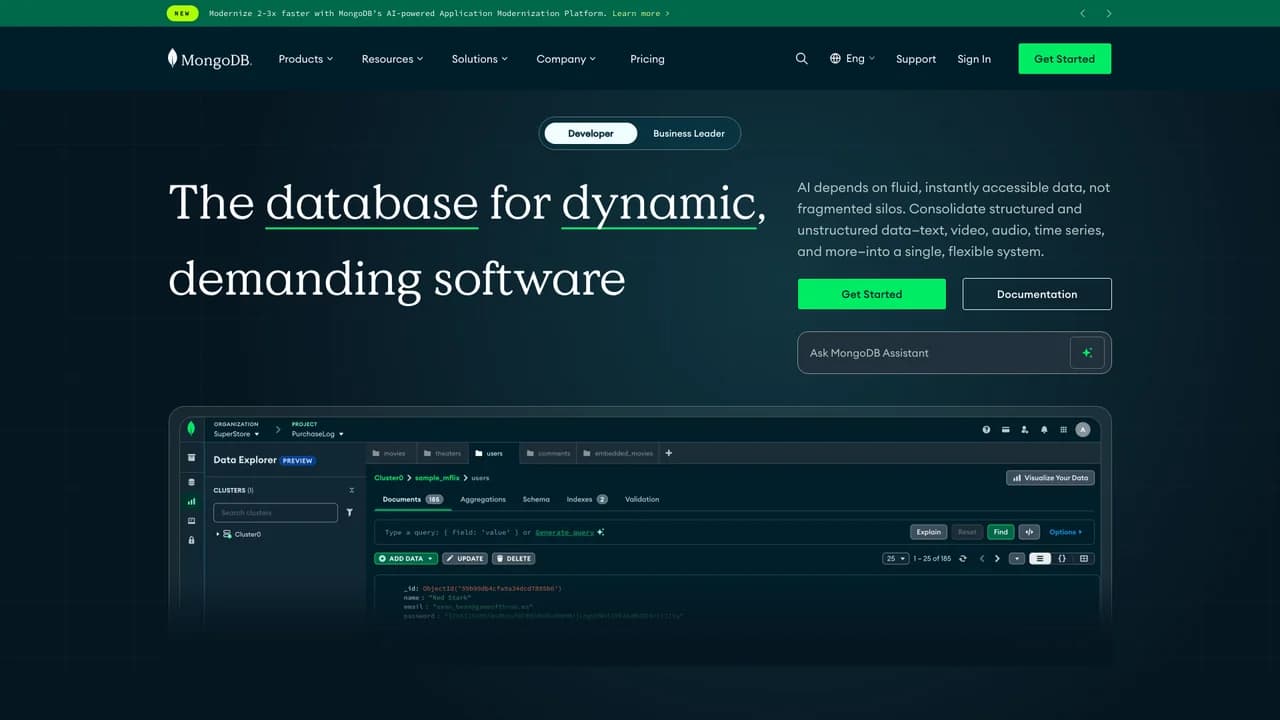
MongoDB ist eine moderne, verteilte Dokumentendatenbank, die Daten in flexiblen, JSON-artigen Dokumenten mit dynamischen Schemata speichert und so eine einfache Abbildung von Anwendungsobjekten ermöglicht. Sie gewährleistet hohe Verfügbarkeit durch integrierte Replikations- und Failover-Mechanismen und erreicht horizontale Skalierung mittels nativem Sharding. MongoDB bietet leistungsstarke Ad-hoc-Abfragen, Indizierung und Echtzeitaggregationsfähigkeiten. Sie kann lokal installiert oder über MongoDB Atlas als vollständig verwalteter Cloud-Dienst genutzt werden, was eine nahtlose Bereitstellung und Skalierung in Multi-Cloud-Umgebungen ermöglicht. Mit einem Ökosystem, das umfassende Entwicklungstools, Integrationen und Sicherheitsfunktionen in Unternehmensqualität umfasst, hat sich MongoDB zur bevorzugten Wahl für den Aufbau skalierbarer, datenintensiver Anwendungen in allen Branchen entwickelt.
Hauptfunktionen von mongodb?
Alternativen zu mongodb

dagworks
DAGWorks ist eine SaaS-Plattform, die Data-Science-Teams dabei unterstützt, komplexe Modell-Pipelines effizienter und transparenter zu erstellen, auszuführen und zu warten. Aufbauend auf Hamilton, einem Open-Source-Python-Framework, das Datentransformationen als modulare, abhängigkeitsbewusste Funktionen strukturiert, bietet DAGWorks eine einheitliche Schnittstelle zur Beobachtung von Code- und Data-Lineage, zum Debuggen von Fehlern sowie zur nahtlosen Integration in bestehende MLOps-Infrastrukturen. Dieser Ansatz verringert den Verwaltungsaufwand für ML-Pipelines bei der Skalierung von Teams und ermöglicht es Data Scientists, schneller zu innovieren, ohne stark auf spezialisierte Softwareentwicklungsressourcen angewiesen zu sein.

elastic-stack
Der Elastic Stack (ehemals ELK) ist eine leistungsstarke Suite von Tools, bestehend aus Elasticsearch, Kibana, Beats und Logstash. Sie ermöglicht die Erfassung und Transformation von Daten aus verschiedenen Quellen sowie deren Echtzeit-Suche, -Analyse und -Visualisierung. Die Suite unterstützt die Bereitstellung On-Premises, in der Cloud und über Managed Services wie Elastic Cloud.

cloudera
Cloudera ist eine führende hybride Datenplattform, die entwickelt wurde, um unvergleichliche Flexibilität und Kontrolle für Datenmanagement, Analysen und Sicherheit in Multi-Cloud- und On-Premises-Infrastrukturen zu bieten. Die Plattform integriert Data Engineering, Data Warehousing, Stream-Verarbeitung und KI-Fähigkeiten in ein einheitliches Ökosystem und beschleunigt so datengesteuerte Entscheidungsfindung und KI-Innovation. Cloudera ermöglicht skalierbare, sichere und regulierte Daten-Workflows und befähigt Unternehmen, maschinelle Lernmodelle, Echtzeitanalysen und unternehmenskritische Anwendungen einfach zu erstellen und zu betreiben.

influxdb
InfluxDB ist eine Datenbank, die speziell für Hochdurchsatz-Zeitreihendaten entwickelt wurde und außergewöhnliche Geschwindigkeit und Effizienz bietet. Sie ist in Rust entwickelt und mit Technologien wie Apache Flight, DataFusion, Arrow und Parquet integriert, was hochperformante Echtzeitabfragen und Analysen mit extremen Komprimierungsfähigkeiten ermöglicht. Die Unterstützung einer speicherlosen Architektur und Objektspeicherung bietet flexible und kosteneffiziente Datenverwaltung. InfluxDB integriert sich nahtlos mit mehreren Programmiersprachen und umfasst eine integrierte Python-Unterstützung für benutzerdefinierte Datenverarbeitung, wodurch sie weitreichend für Anwendungsfälle wie Monitoring, IoT, Finanzanalysen und operativen Betrieb geeignet ist.

airbyte
Airbyte ist eine Open-Source-Datenintegrations-Engine, die entwickelt wurde, um Datenintegrationsprozesse zu vereinfachen und zu beschleunigen. Sie unterstützt über 600 Connectors und ermöglicht Unternehmen, Daten aus Datenbanken, SaaS-Anwendungen, APIs und anderen Quellen effizient mit Data Warehouses, Data Lakes und ähnlichen Speicherlösungen zu synchronisieren. Dank einer flexiblen Architektur ist Airbyte sowohl mit selbstgehosteten als auch mit Cloud-Bereitstellungen kompatibel und eignet sich somit gleichermaßen für kleine Teams und große Unternehmen, während sie skalierbare, sichere und anpassbare Datenpipeline-Anforderungen erfüllt. Ihre Fähigkeiten in der Integration unstrukturierter Daten, die Unterstützung von Vektordatenbanken und die Kompatibilität mit generativen KI-Workflows machen sie zu einem Kernwerkzeug für moderne datengetriebene KI-Anwendungen.

openreplay
OpenReplay bietet eine All-in-One-User-Experience-Plattform, die Session-Replay, Produktanalysen, Leistungsüberwachung, Fehlertracking und kollaborative Browsing-Tools integriert. Sie hilft Teams, Nutzerverhalten visuell zu verstehen, Probleme zu identifizieren, die Produktleistung zu optimieren und durch Self-Hosting eine umfassende Kontrolle über die Datenschutz-Compliance zu erlangen. Die Plattform unterstützt die Aufzeichnung von Web- und Mobilanwendungen, bietet entwicklerorientierte Debugging-Tools und ermöglicht Echtzeit-Kundensupport-Funktionen wie Co-Browsing und Videoanrufe.


