
geekbench
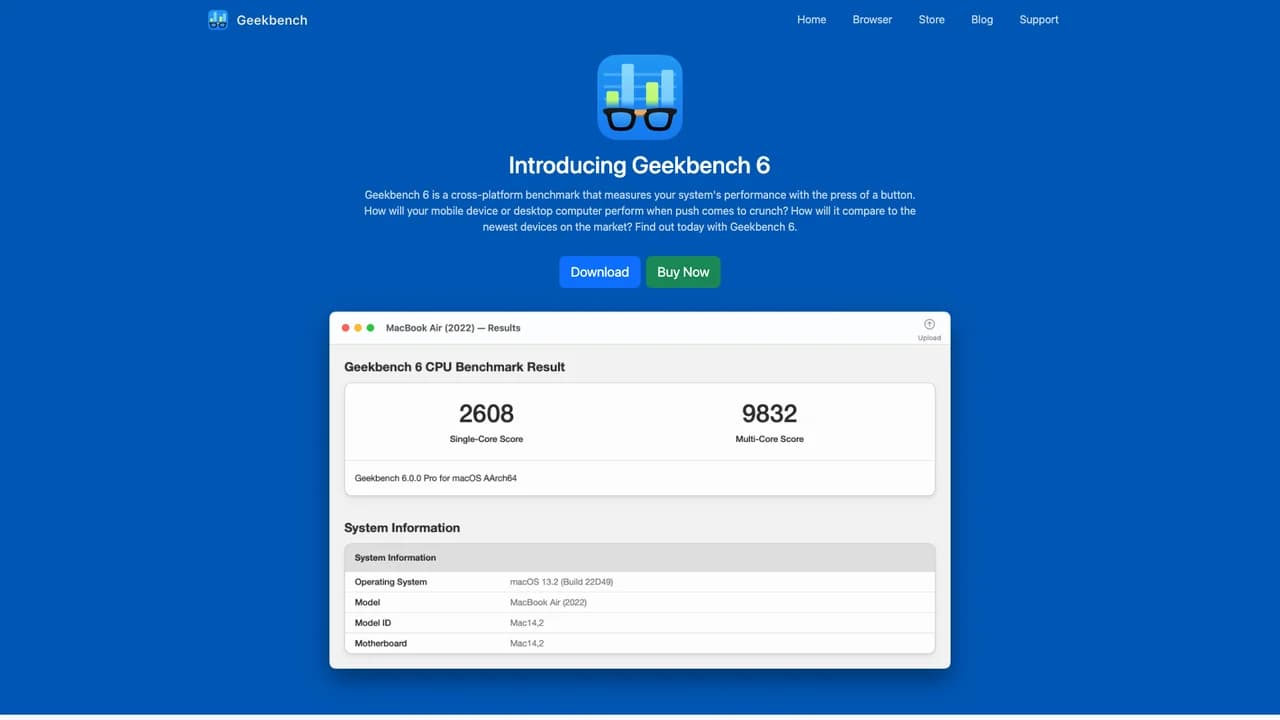
أداة قياس أداء متعددة الأنظمة تقيس درجات الأداء أحادية النواة ومتعددة النواة للمعالج، بالإضافة إلى درجات الحوسبة لوحدة معالجة الرسوميات.
الزيارات الشهرية
1.1M
متوسط مدة الجلسة
1 min
ترتيب الفئة
#141
معدل الارتداد
0.4%
ما هو geekbench؟
جي كبنش هو أداة تقييم أداء شاملة مصممة لتقييم أداء المعالج ووحدة معالجة الرسوميات في أجهزة الكمبيوتر والهواتف الذكية والأجهزة اللوحية. وهو يدعم أنظمة تشغيل متعددة تشمل: macOS وWindows وLinux وAndroid وiOS. من خلال محاكاة مهام واقعية مثل معالجة الصور والتعلم الآلي، يقدم جي كبنش درجات تفصيلية لأداء المعالج أحادي النواة ومتعددة النواة، بالإضافة إلى قدرات الحوسبة لوحدة معالجة الرسوميات.
الميزات الرئيسية لـ geekbench?
بدائل لـ geekbench

responsible-ai-institute
معهد الذكاء الاصطناعي المسؤول (RAI Institute) هو منظمة غير ربحية مستقلة مكرسة لتطوير اعتماد الذكاء الاصطناعي الموثوق عبر الصناعات. يقدم المعهد أدوات حوكمة ذكاء اصطناعي قابلة للتطبيق، وبرامج اعتماد وتصديق، وخدمات مراقبة للمخاطر مصممة لتمكين التنفيذ واسع النطاق للذكاء الاصطناعي المسؤول. يتعاون المعهد مع مختبرات أكاديمية عالمية، وصناع السياسات، ومزودي الذكاء الاصطناعي لضمان التوافق مع اللوائح المتطورة ومعايير الصناعة. تشمل عروض المنتجات الخاصة به تقييم الذكاء الاصطناعي بالمقارنة، وأتمتة الامتثال، وبرامج تطوير مهارات القوى العاملة لدعم نشر الذكاء الاصطناعي الأخلاقي والعادل والشفاف.

transluce
ترانسليس هي منظمة بحثية غير ربحية مكرّسة لتطوير تقنيات الذكاء الاصطناعي من خلال الكشف عن الآليات الداخلية للنماذج المعقدة. عن طريق توليد أوصاف عالية الجودة يسهل على الإنسان فهمها لمكونات الخلايا العصبية تلقائيًا، وتوفير واجهة مراقبة تفاعلية، تمكن ترانسليس الباحثين والمستخدمين من فهم واستفسار وتوجيه سلوك الذكاء الاصطناعي بشكل أفضل. جميع الأدوات قابلة للتوسع ومفتوحة المصدر، مما يحفز معايير الصناعة لسلامة الذكاء الاصطناعي وشفافيته. يعتمد نهج ترانسليس على وكلاء الذكاء الاصطناعي لتحليل نماذج اللغة الكبيرة، وكشف السلوكيات الخفية، ودعم نشر الذكاء الاصطناعي المسؤول عبر أساليب تم التحقق من صحتها مجتمعيًا.

evidently-ai
إيفيدينتلي إيه آي هو حل شامل مُصمَّم لمساعدة الفرق في بناء وتقييم وصيانة منتجات الذكاء الاصطناعي عالية الموثوقية، حيث يغطي كلاً من نماذج التعلم الآلي التقليدية وتطبيقات نماذج الذكاء الاصطناعي اللغوية الكبيرة (LLM). وهو يتضمن مكتبة برمجية مفتوحة المصدر بلغة بايثون تضم أكثر من 100 مقياس تقييم مدمج، بالإضافة إلى منصة سحابية تدعم اختبار ومراقبة الذكاء الاصطناعي، وإنشاء البيانات الاصطناعية، وسير العمل التعاوني. تتيح منصة إيفيدينتلي إيه آي للمستخدمين اكتشاف انحراف البيانات والتنبؤات، وإجراء اختبارات الانحدار والاختراق، وإدارة مجموعات البيانات والتقييمات من خلال واجهة بديهية، مما يضمن جودة الذكاء الاصطناعي طوال دورة حياة المنتج بالكامل.

ballpark
Ballpark هي منصة سريعة وبديهية تساعد فرق المنتجات على جمع ملاحظات قابلة للتنفيذ من المستخدمين طورة دورة حياة التطوير. فهي تتيح اختبار المواقع الإلكترونية ونماذج Figma الأولية والنصوص التسويقية وعروض المنافسين – دون حاجة إلى تثبيت. تدمج Ballpark الاستبيانات والمهام التفاعلية والتسجيل الصوتي-المرئي لالتقاط ردود فعل المستخدمين الأصيلة ورؤى معمقة. مع إمكانية الوصول إلى لوحة كبيرة عالمية للمستجيبين وخيارات فلترة موسعة، يمكن للفرق تجنيد مختبرين ذوي صلة بسرعة. المقاعد غير المحدودة للفريق وميزات التعاون تجعل البحث ديمقراطياً عبر المؤسسات، مما يمكّن من اتخاذ قرارات قائمة على البيانات ويُختصر الجداول الزمنية للمشاريع ويُحسّن مناسبة المنتج للسوق.

confident-ai
Confident AI هي منصة تقييم قوية مبنية على إطار العمل مفتوح المصدر DeepEVM، مصممة لمساعدة الفرق على اختبار وتحسين تطبيقات نماذج اللغة الكبيرة (LLM) بشكل منهجي. تدعم المنصة سير عمل تقييم كامل - بدءًا من إنشاء مجموعات البيانات والمقاييس المخصصة وحتى المراقبة المستمرة في مرحلة الإنتاج - مما يمكّن المؤسسات من مقارنة نماذج اللغة الكبيرة المختلفة، واكتشاف حالات التراجع في الأداء، وتحسين الأداء باستخدام مقاييس وحواجز رائدة في القطاع تعتمد على السيناريوهات. تعزز Confident AI التعاون بين أعضاء الفريق الفنيين وغير الفنيين، وتندمج بسلاسة مع خطوط أنابيب CI/CD، وتوفر إمكانات ذات مستوى مؤسسي تشمل النشر الداخلي، وتسجيل الدخول الموحد SSO، والامتثال لمتطلبات HIPAA.

ragas
Ragas هي مكتبة مفتوحة المصدر قوية ومرنة مصممة لتقييم نماذج اللغة الكبيرة (LLM) وخطوط أنابيب RAG. تقدم مجموعة شاملة من مقاييس التقييم الآلي التي تغطي أبعادًا مثل الدقة الواقعية والتماسك والملاءمة، مع دعمها أيضًا لتوليد بيانات اختبار اصطناعية والمراقبة عبر الإنترنت. تتيح Ragas إجراء قياس أداء متوافق مع المعايير الصناعية وتسمح بتخصيص مسارات عمل التقييم لتلبية الاحتياجات المتنوعة في بيئات البحث والإنتاج. تساعد قدراتها القوية على التكامل المطورين والباحثين على تحسين وضمان موثوقية تطبيقات الذكاء الاصطناعي.


